作者:Tong Zeng、Srivathsan Badrinarayanan、Janghoon Ock
时间:2025 年 10 月
来源:arXiv
背景
化工过程优化的常规方法,无论是梯度求解器 IPOPT、SNOPT,还是网格搜索、进化算法、贝叶斯优化,都要求先给出完整的设计空间,也就是每个决策变量的上下界。新工艺和改造项目往往拿不出这些边界,工程师只能凭经验估计,估计的结果因人而异。IDAES、Pyomo 这类建模平台同样要求用户先写好变量边界和光滑的目标函数。作者把这件事叫”约束定义瓶颈”。
已有的大模型工作大多停在合成路线规划、材料发现或控制系统设计这些单步决策上,很少进入稳态流程仿真和过程优化,用多智能体从文字描述里自动生成操作约束的工作更少。
核心贡献
作者声称的贡献有两点:
- 只给一段简短的工艺描述,由大模型自动推断各决策变量的操作边界,不需要预先给定。
- 在推断出的边界内,由多个智能体协作完成优化。智能体用自然语言说明每一步为什么这样调参数,搜索过程可以解释。
论文同时强调两点实用性:不要求目标函数可导,也不需要训练模型或 GPU,只调用 API。
方法
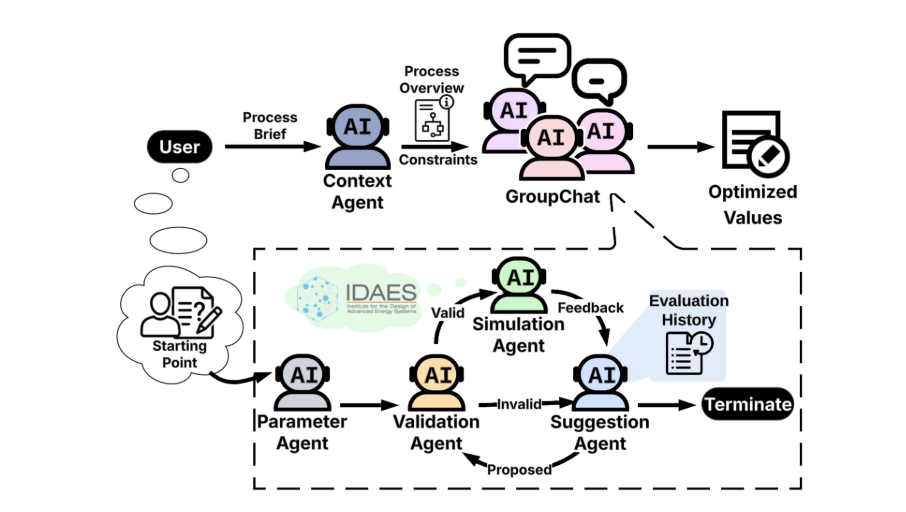
系统建在 AutoGen 的 GroupChat 上,用 OpenAI 的 o3,分两个阶段。
第一阶段,约束生成。 ContextAgent 单独工作。它拿到工艺描述后,凭模型自带的领域知识推断每个决策变量的上下界,并写出一份工艺概述。为了压低随机性,同样的提示独立运行 5 次,对每个变量的上下界取平均,作为后续优化使用的边界。
第二阶段,迭代优化。 四个智能体按固定顺序协作:
- ParameterAgent 接收用户给的初值。初值可以任意,甚至可以越界。
- ValidationAgent 把参数和边界对比,越界就指出是哪个变量。
- SimulationAgent 调用预先建好的 IDAES 模型,计算成本、收率或收率成本比。
- SuggestionAgent 保存全部历史记录,根据趋势提出下一组参数的相对增量。它判断改进已经变小时,输出 TERMINATE,优化结束。
发言顺序由一个选择函数决定,依据是上一个发言者和消息内容,避免来回重复。论文把”自主”定义为:每个智能体只依靠内置领域知识、生成的约束和共享历史,不需要人介入就能推理、行动、迭代。
实验
实验对象是 IDAES 自带的甲苯加氢脱烷基(HDA)流程,把甲苯转化成苯。流程包含混合器、加热炉、反应器、两个闪蒸罐、分流器和压缩机,反应器单程转化率固定为 75%,热力学用理想汽液平衡。决策变量有 4 个:加热炉出口温度、两个闪蒸罐的温度、第二个闪蒸罐的压降。
三个评价指标:
- 年操作成本,只含加热和冷却的公用工程费用,不含固定费用和投资。
- 年产量,取反应器出口苯的摩尔流量折算。
- 收率成本比,用前两者相除。
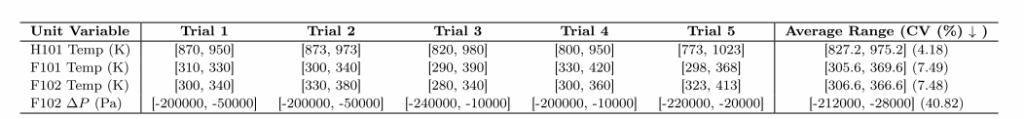
约束质量。 5 次独立生成的边界,温度类变量的变异系数低于 10%,压降约 40%。加热炉温度的平均区间是 [827.2, 975.2] K,和文献报道的工业范围 [773, 977] K 接近。
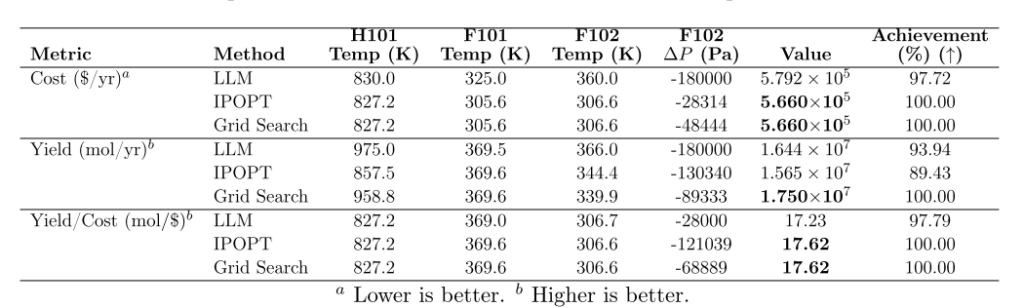
优化结果。 对比对象是 IPOPT 和网格搜索,网格在每个变量上取 10 个离散点,共 10⁴ 个组合,全部使用上面取平均后的边界。以网格搜索的目标值为基准,大模型框架在三个指标上分别达到 97.72%(成本)、93.94%(收率)和 97.79%(收率成本比)。收率这一项上它还高于 IPOPT 的 89.43%。
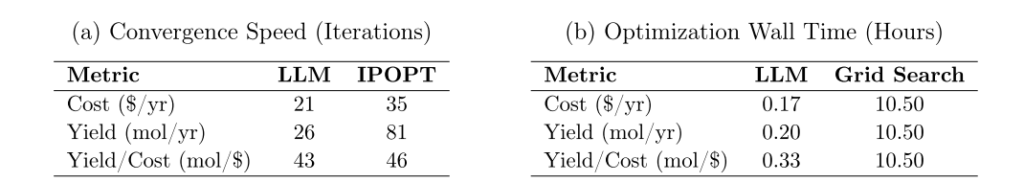
效率。 大模型框架用 21 到 43 次迭代收敛,三个指标都在 20 分钟以内完成;网格搜索固定需要 10.5 小时,作者据此称快 31 倍。收率优化上 IPOPT 用了 81 次迭代,框架只用 26 次。
可解释性。 作者放宽输出长度限制后再跑一次成本最小化,智能体给出的理由是:炉温尽量靠近下界以减少燃料,两个闪蒸罐温度推向区间上端以减少制冷,第二个闪蒸罐的压降取机械上允许的最小值。
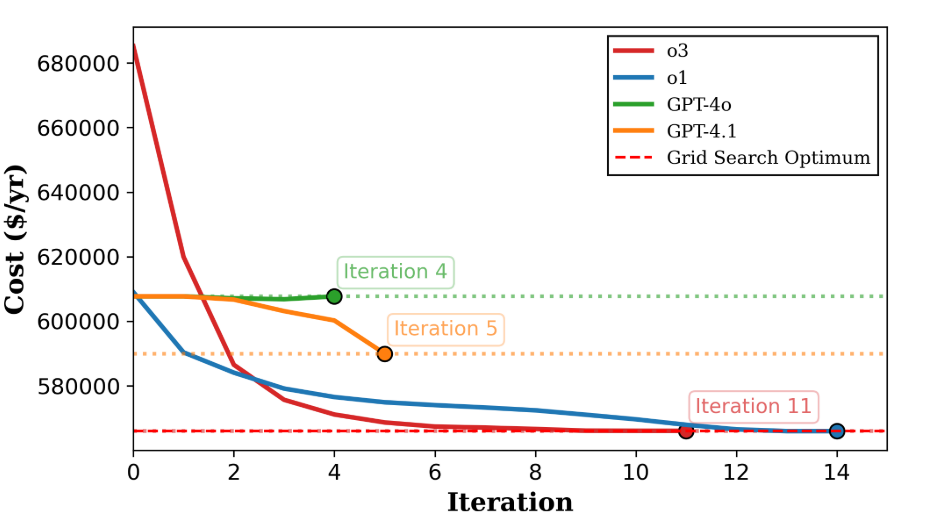
模型对比。 同样的提示、边界和历史记录下,只有 o3 和 o1 能收敛到接近网格搜索的解,分别用 11 和 14 次迭代;GPT-4o 和 GPT-4.1 在 4 到 5 次迭代后就停在较差的解上。
结论
大模型智能体能从最少的工艺描述里生成工程上合理的操作边界,并在边界内迭代优化,从而在传统方法无法直接使用的场景里完成过程优化。在 HDA 流程上,它与 IPOPT 和网格搜索的解质量相当,计算时间大幅缩短,而且每一步的取舍都能用自然语言说清楚。作者认为这降低了过程优化的专业门槛,后续可以和工艺数据库、常规优化器结合,并扩展到流程合成。