作者:Ming Jin;Shiyu Wang;Lintao Ma;Zhixuan Chu;James Y. Zhang;Xiaoming Shi;Pin-Yu Chen;Yuxuan Liang;Yuan-Fang Li;Shirui Pan;Qingsong Wen
来源:International Conference on Learning Representations(ICLR 2024)
时间:2024年
单位:Monash University;Ant Group;IBM Research;Griffith University;Alibaba Group;The Hong Kong University of Science and Technology(Guangzhou)
一、研究背景
时间序列预测广泛应用于能源负荷预测、交通预测、需求规划以及气候建模等领域。传统统计模型和深度学习模型能够学习历史数据中的变化规律,但通常需要针对具体任务进行训练,在历史数据不足或数据分布发生变化时,模型的预测效果可能受到影响。
近年来,大语言模型通过大规模文本预训练,在多种任务中表现出较强的模式识别和迁移能力。因此,研究者开始探索能否利用已有语言模型处理时间序列,从而减少对大量领域数据和专门模型设计的依赖。
然而,时间序列与自然语言之间存在明显差异。时间序列由连续数值构成,而语言模型主要处理离散文本标记。直接将数值转成文字输入语言模型,可能面临输入过长、数值精度处理困难以及输出格式不稳定等问题;对整个语言模型进行微调,又会带来较高的训练和存储成本。
针对这些问题,本文提出Time-LLM框架,通过模型重编程将时间序列转换为适合语言模型处理的表示,并结合自然语言提示提供背景和任务信息。在保持语言模型主体参数不变的情况下,仅训练输入转换模块和输出预测模块,实现时间序列预测。
二、核心贡献
本文提出了Time-LLM框架,将冻结的预训练语言模型用于时间序列预测。模型通过文本原型对时间序列片段进行表示转换,并通过Prompt-as-Prefix机制补充数据背景、任务要求和输入统计信息。
本文的主要贡献可以概括为:
1、提出基于模型重编程的时间序列预测框架,在不更新语言模型主体参数的情况下,学习输入转换模块和输出预测模块。
2、提出Patch Reprogramming方法,通过文本原型和多头交叉注意力,将时间序列片段映射到与语言模型相适配的表示空间。
3、提出Prompt-as-Prefix机制,将数据集背景、预测任务和统计特征作为文字前缀,为时间序列建模提供额外信息。
4、在长期预测、短期预测、少样本学习和跨数据集迁移任务中进行实验,验证框架的预测性能和数据利用效率。
三、研究方法
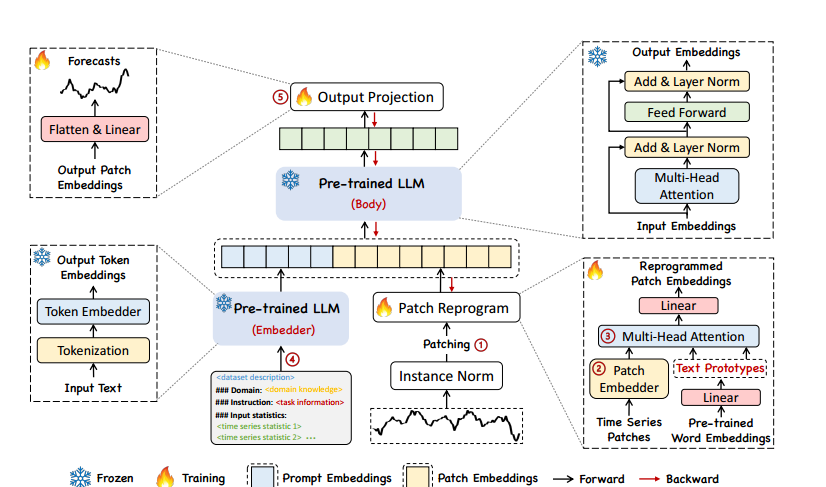
本文将多变量时间序列拆分为多个单变量序列,各变量分别经过输入转换、语言模型处理和输出预测。模型主要包括输入嵌入、片段重编程、提示前缀、冻结语言模型和输出投影五个部分。
(1)输入标准化与片段嵌入
首先,使用可逆实例归一化方法(RevIN)对每个输入序列进行标准化,使其具有零均值和单位标准差,以缓解不同样本之间的尺度差异和分布变化。
随后,将历史序列划分为若干连续片段,即patch。这些片段可以重叠,也可以不重叠,每个片段通过线性层转换为向量表示。与逐个时间点输入相比,片段能够聚合局部变化信息,同时减少输入序列的长度。
(2)片段重编程(Patch Reprogramming)
时间序列片段经过嵌入后,仍然与语言模型预训练时接触的文字表示存在差异。因此,作者从语言模型的词嵌入矩阵中,通过可学习的线性映射构造一组规模较小的文本原型。
随后,模型采用多头交叉注意力,将时间序列片段表示作为Query,将文本原型转换为Key和Value,使不同片段学习如何组合相关原型,形成重编程后的表示。
例如,一个片段可能呈现短期上升或持续下降的变化模式,模型可以借助与这些模式相关的语言表示进行编码。这里的“文本原型”是可学习的连续向量,并不是先将每段时间序列转换成一句文字描述。
(3)提示作为前缀(Prompt-as-Prefix)
为了提供额外背景,作者将自然语言提示放在时间序列片段表示之前。提示主要包含三类信息:
数据集背景:说明数据所属领域及其含义。
任务指令:说明需要根据过去多少步数据预测未来多少步。
输入统计信息:包括最小值、最大值、中位数、整体趋势和主要自相关滞后。
其中,主要滞后通过自相关计算获得,用于提供与周期性和时间依赖有关的信息。提示经过语言模型原有的文本嵌入层后,与重编程后的片段表示拼接,共同输入语言模型。
(4)冻结语言模型与输出预测
本文默认使用Llama-7B作为主干模型,并在实验中比较了GPT-2和减少Transformer层数的模型版本。训练过程中,语言模型主体参数保持冻结,仅更新输入转换和输出预测部分。
经过语言模型处理后,模型丢弃提示前缀对应的输出,保留时间序列片段对应的隐藏表示,再将其展平并通过线性层映射为未来多个时间步的预测值。
因此,整个方法可以概括为:
历史时间序列 → RevIN标准化 → 片段划分与嵌入 → 基于文本原型的重编程 → 拼接提示前缀 → 冻结的语言模型 → 输出投影 → 未来数值预测
四、实验
本文在多个公开数据集上进行实验,默认使用完整的32层Llama-7B作为主干。实验在NVIDIA A100-80GB GPU上开展,各实验重复三次并报告平均结果。
长期预测使用ETTh1、ETTh2、ETTm1、ETTm2、Weather、Electricity、Traffic和ILI数据集。除ILI外,主要预测长度为96、192、336和720步;ILI的预测长度为24、36、48和60步。长期预测主要采用均方误差(MSE)和平均绝对误差(MAE)评价。
短期预测主要使用M4数据集,预测长度为6—48步,评价指标包括对称平均绝对百分比误差(SMAPE)、平均绝对缩放误差(MASE)和总体加权平均指标(OWA)。
对比模型包括PatchTST、GPT4TS、DLinear、TimesNet、FEDformer、Autoformer等;短期预测还比较了N-HiTS和N-BEATS。
(1)长期与短期预测结果
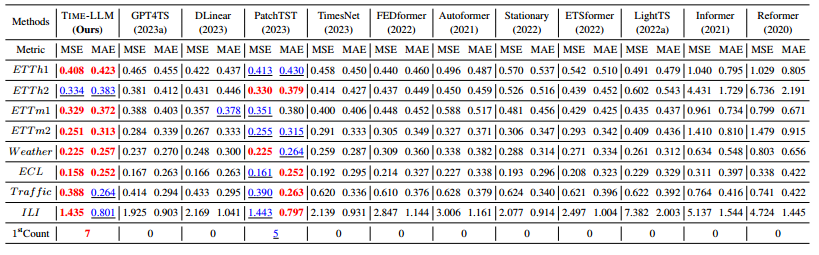
长期预测结果表明,Time-LLM在多数数据集上具有较好的表现,但并非所有指标都最优。例如,表1中:
ETTh1:Time-LLM的MSE为0.408,PatchTST为0.413,GPT4TS为0.465。
ETTm1:Time-LLM的MSE为0.329,PatchTST为0.351,GPT4TS为0.388。
Electricity:Time-LLM的MSE为0.158,PatchTST为0.161,GPT4TS为0.167。
ETTh2:Time-LLM的MSE为0.334,略高于PatchTST的0.330。
作者报告,相比PatchTST,Time-LLM的平均MSE降低约1.4%。这说明模型具有竞争力,但在完整训练数据条件下,相对强基线的总体提升幅度较小。
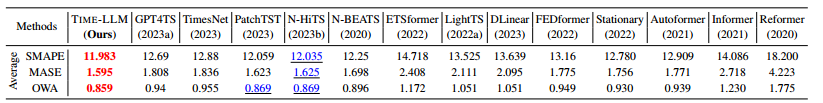
在M4短期预测中,Time-LLM的SMAPE、MASE和OWA分别为11.983、1.595和0.859。其中,PatchTST和N-HiTS的OWA均为0.869,GPT4TS为0.940,Time-LLM取得了更低的总体预测误差。
(2)少样本与零样本预测结果
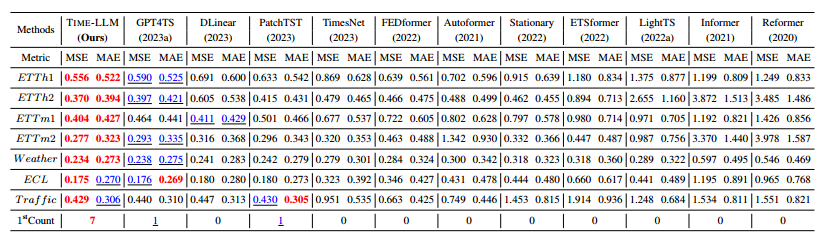
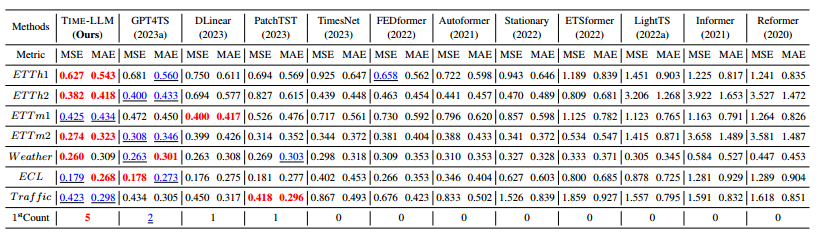
少样本实验仅使用原训练时间段前10%或5%的数据训练模型。结果表明,在数据有限的情况下,Time-LLM总体上仍具有较好的预测表现。例如,使用10%训练数据时,ETTh2上的MSE为0.370,优于GPT4TS的0.397和PatchTST的0.415。
需要注意,这里的少样本学习仍然会训练输入转换模块和预测头,并不是只在提示中提供少数示例。
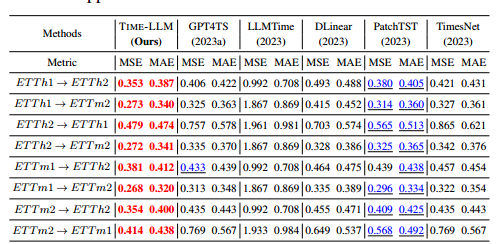
零样本实验采用跨数据集迁移方式,即在一个数据集上训练,再直接在另一个数据集上测试。例如,在ETTh1上训练并迁移至ETTh2时,Time-LLM的MSE为0.353,优于PatchTST的0.380和GPT4TS的0.406。
因此,本文的零样本能力指不使用目标数据集进行训练,而不是完全不经过时间序列训练即可预测。相关实验主要在ETT数据集之间开展,对更大领域差异的迁移效果仍需进一步验证。
(3)消融与效率分析
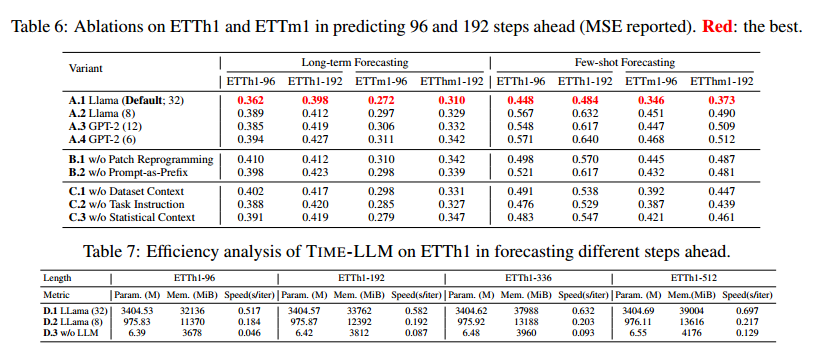
消融实验显示,去掉片段重编程或提示前缀均会导致预测性能下降。例如,在ETTh1预测未来96步时,完整模型的MSE为0.362,去掉片段重编程后上升至0.410,去掉提示前缀后上升至0.398。这表明两部分设计在实验设置中均有作用。
效率方面,作者报告重编程网络的可训练参数少于660万。但冻结语言模型并不意味着整体运行成本很低:完整Llama配置在表7中的显存占用约为32136—39004 MiB,说明主干模型仍带来较高的计算和显存开销。
五、总结
本文的核心思想是:
通过学习时间序列与语言表示之间的转换关系,并结合自然语言提示,使冻结的大语言模型能够参与时间序列预测。
与更新语言模型主体参数的方法相比,Time-LLM将训练集中在输入转换模块和输出预测模块上。实验表明,该框架在多种预测任务中具有竞争力,尤其在训练数据有限和跨数据集迁移的情况下表现较好。
不过,模型仍存在一定局限。首先,相对PatchTST等强基线,完整数据条件下的平均性能提升较小。其次,大语言模型带来的显存和计算成本仍然较高。此外,模型分别处理各输入变量,没有显式建模变量之间的交互关系。论文的预测结果支持框架有效,但尚不足以单独证明性能提升来自语言模型的语义推理能力。