作者:Siyan Dong1* Shuzhe Wang2* Shaohui Liu3 Lulu Cai1
Qingnan Fan4 Juho Kannala2,5† Yanchao Yang1†
单位:¹香港大学 ²阿尔托大学 ³苏黎世联邦理工学院 ⁴维沃移动通信 ⁵奥卢大学
来源:CVPR2025
背景
视觉定位(Visual Localization) 旨在根据查询图像和带有已知位姿的参考图像数据库,估计查询相机在世界坐标系中的 6DoF 位姿,即三维位置与旋转朝向。
传统基于几何结构的定位方法 通常利用特征匹配、三维重建和几何求解估计相机位姿,虽然定位精度较高,但特征匹配与鲁棒估计的计算开销较大,难以兼顾实时性。
绝对位姿回归(APR)能够直接从图像预测相机位置和朝向,推理速度快,但通常需要针对每个新场景单独训练,并依赖密集视角覆盖,跨场景泛化能力不足。
相对位姿回归(RPR) 通过预测查询图像与参考图像之间的相对位姿实现跨场景定位,但现有方法精度有限,且单对图像难以准确恢复具有真实尺度的相机平移。
研究目标: 提出 Reloc3r 框架,通过大规模相对位姿学习与多参考图像几何聚合,实现无需场景专用训练、兼具高精度与高推理效率的视觉定位。
贡献
提出简洁的 Reloc3r 视觉定位框架: 将相对相机位姿回归网络与运动平均(Motion Averaging)模块相结合,由图像对的相对位姿预测恢复查询图像在参考数据库坐标系下的绝对位姿。
设计完全对称的相对位姿回归网络: 基于 DUSt3R 的 ViT Encoder-Decoder 架构,通过双分支参数共享与交叉注意力,直接预测图像对之间的相对旋转和相对平移方向,减少模型复杂度与图像顺序偏差。
提出不依赖度量尺度的位姿学习方式: 网络仅学习相对旋转和单位平移方向,通过角度损失统一监督,避免不同场景的尺度差异及旋转、平移损失权重平衡问题;真实尺度在后续几何求解阶段恢复。
利用大规模多场景训练提升泛化能力: 汇集约 800 万对具有位姿标注的图像,覆盖物体、室内和室外场景,在六个公开数据集上验证模型的定位精度、推理效率和跨场景泛化能力。
方法
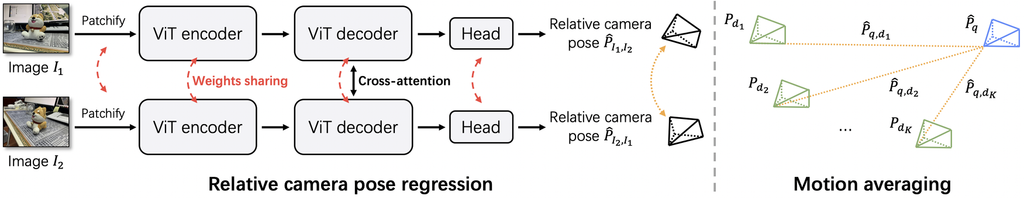
Reloc3r 由两部分构成:相对相机位姿回归网络 + 运动平均模块。
核心方法流程
(1) 参考图像检索: 输入一张查询图像Iq,利用 NetVLAD 从带有已知相机位姿的参考数据库中检索 Top-K 相似图像,构建查询—参考图像对。
(2) 相对位姿回归: 将每对图像输入共享参数的双分支 ViT 网络,经 Encoder 提取特征、Decoder 进行交叉注意力交互,再由回归头直接预测两幅图像之间的相对旋转及平移方向。
(3) 无尺度位姿学习: 使用旋转角度误差和平移方向角度误差作为监督信号,仅学习相机间的相对朝向与移动方向,不要求网络直接预测真实平移距离。
(4) 旋转平均: 结合参考图像的已知绝对旋转与网络预测的相对旋转,计算多个查询相机旋转估计,通过四元数旋转聚合及中位数策略降低预测噪声。
(5) 相机中心三角化: 将多个参考相机的已知位置与预测的相对平移方向构成空间射线,使用最小二乘法和 SVD 求解查询相机中心,恢复具有真实尺度的三维坐标。
最终输出: 查询图像在参考数据库世界坐标系下的绝对 6DoF 位姿。
实验
1、实验准备
训练数据: 从 CO3Dv2、ScanNet++、ARKitScenes、BlendedMVS、MegaDepth、DL3DV 和 RealEstate10K 共七个公开数据集中构建约 800 万对带真实相对位姿的图像,覆盖物体、室内及室外场景。
模型训练: 使用 DUSt3R 预训练权重初始化,采用 24 层 ViT Encoder、12 层 Decoder 和位姿回归头,在 8 张 AMD MI250X GPU 上训练。
模型评估: 在六个公开数据集上评估,包括相对位姿估计、绝对视觉定位和消融实验。使用 AUC@5/10/20、RRA@15、RTA@15、mAA@30,以及位置误差(m)和旋转误差(°)作为评价指标。
2、实验结果
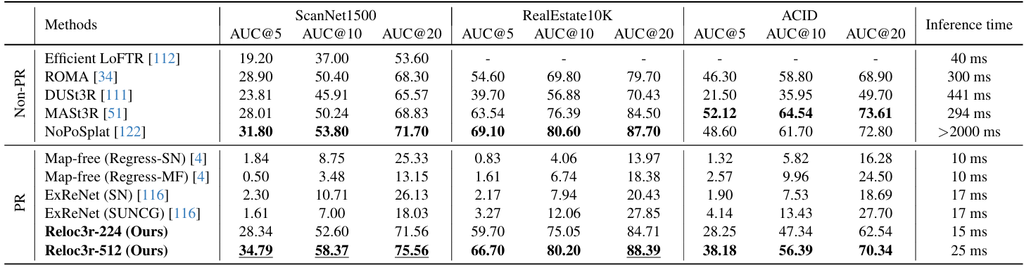
(1) Reloc3r 在 ScanNet1500 上取得 34.79% 的 AUC@5,优于 DUSt3R 的 23.81% 和 MASt3R 的 28.01%,说明直接进行位姿回归也可以实现高精度相对位姿估计。
(2) 在 RealEstate10K 数据集上,Reloc3r-512 的 AUC@5 达到 66.70%,表现接近 NoPoSplat;在训练时完全未见过的 ACID 数据集上,AUC@20 达到 70.34%,体现了一定的跨数据集泛化能力,但并非所有指标均最优。
(3) Reloc3r-512 在表 3 中报告的单图像对推理时间为 25 ms,明显快于 MASt3R 的 294 ms 和 DUSt3R 的 441 ms。该时间不代表包含 Top-K 检索与全部图像对处理的完整定位耗时。
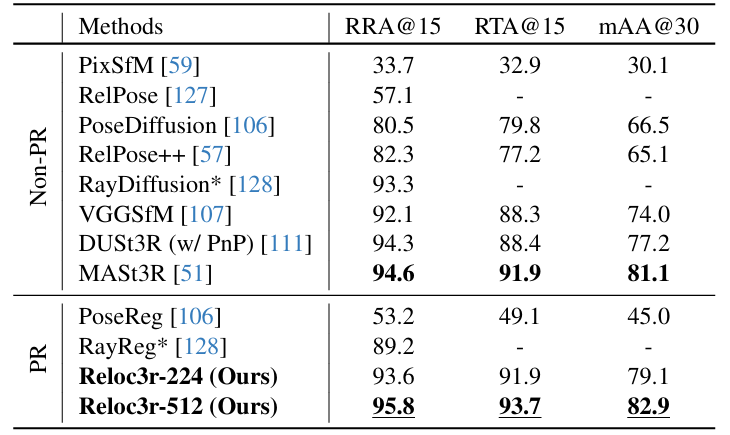
(1) 在 CO3Dv2 数据集上,Reloc3r-512 的相对旋转精度 RRA@15 达到 95.8%,相对平移方向精度 RTA@15 达到 93.7%,综合指标 mAA@30 达到 82.9%。
(2) 相比 DUSt3R、MASt3R 等方法,Reloc3r 在三个指标上均取得更优结果,说明其在大视角变化、多相机配置下具有较好的相对位姿预测能力。
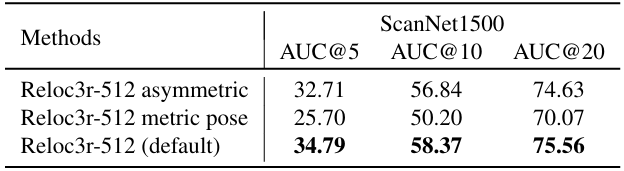
(1) 对称网络结构: 采用双分支共享参数的对称网络,AUC@5 从非对称结构的 32.71% 提升到 34.79%,说明对称设计有助于相对位姿学习,同时能够降低网络复杂度。
(2) 无尺度位姿学习: 直接回归带真实尺度的相对位姿时,AUC@5 仅为 25.70%;改为只学习相对旋转与平移方向后提升至 34.79%,验证了不依赖度量尺度的回归策略更有效。
(3) 输入分辨率: 512 分辨率整体优于 224 分辨率,但计算开销增加,说明模型存在一定的精度与效率权衡。
总结
(1) 提出 Reloc3r 视觉定位框架,通过相对位姿回归与运动平均,将查询图像和带已知位姿的参考图像之间的相对几何关系转换为绝对 6DoF 位姿,实现跨场景视觉定位。
(2) 基于 DUSt3R 构建完全对称的双分支 ViT 网络,通过共享参数与交叉注意力直接预测图像对的相对旋转和平移方向,避免传统几何定位复杂的显式特征匹配和鲁棒求解流程。
(3) 采用 无尺度相对位姿学习与多参考图像三角化 的策略,将相对方向预测和真实尺度恢复分离,降低不同场景尺度差异对模型训练的影响。
(4) 通过约 800 万对多场景图像的大规模训练,在多个公开基准上取得较好的相对位姿估计和视觉定位性能,且无需针对新场景重新训练,体现了较强的泛化能力和实时应用潜力。
(5) 论文核心创新并非提出复杂的新几何求解算法,而是通过简洁的相对位姿回归结构、无尺度监督与大规模多场景训练,实现精度、效率和泛化能力的有效平衡。