作者:Jiyeon Kim、Hyunji Lee、Dylan Zhou 等
单位:KAIST AI;UNC Chapel Hill;Google;KRAFTON;Adobe Research;New York University
来源:ACL 2026(Long Papers)
时间:2026.07
链接:Can Large Language Models Keep Up? Benchmarking Online Adaptation to Continual Knowledge Streams
一. 研究背景
假设一个人先在厨房,随后去了花园,最后进入办公室。两个系统最终都回答“办公室”,但一个始终及时更新,另一个直到最后才改对。这个简单例子说明:末次回答正确,可能掩盖中间很长一段时间的错误。
当模型持续接收新资料时,我们需要同时观察两种能力:事实变化后能否跟上,事实没有变化时能否保持正确。OAKS 围绕这两个问题,把一次性的长文问答改造成沿信息流持续进行的评测。
二. 论文概要
OAKS 是面向持续知识流的在线适应评测基准。作者将长文本按顺序分块,每到达一个新块,就向模型提出同一组问题,并根据截至当前可见的内容判断答案。这里的“在线适应”主要体现为利用新增上下文跟踪答案状态。
基准包含两类数据:OAKS-BABI 将可追踪事件穿插在背景文本中,共有 1,224 个问题;OAKS-Novel 对自然小说进行逐步标注,发表版包含 39 本小说、870 个问题。前者采用开放回答,后者采用选择题,用于观察不同情境下的持续状态跟踪。
三. 核心设计:沿时间观察更新与保持
3.1 每个文本前缀都有自己的正确答案
文本按约 2k token 切块。时刻 \(t\) 的模型只能使用截至此时已到达的信息,评测也使用这个前缀对应的标准答案,而不是故事结束后的最终答案。
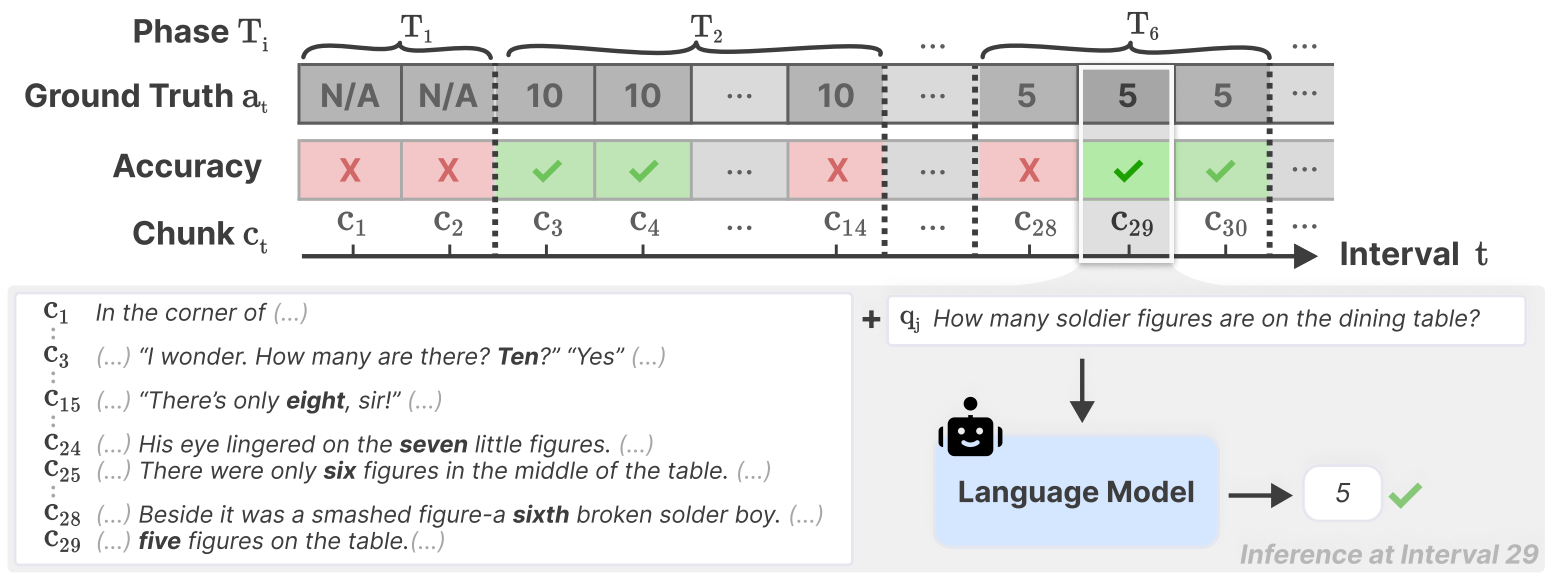
先看图中上方的时间线:灰色行表示各步的正确答案,勾叉表示模型是否答对;下方展示到第 29 个文本块时的一次问答。正确答案连续不变的一段称为 Phase。同一阶段内也可能先对后错,因此“跟上变化”和“保持正确”需要分别观察;A→B→A 则属于三个阶段。
3.2 用错误发生的位置解释总分
OAKS 将每一步的回答分为四类:
- ACC:当前回答正确。
- AL:在最终曾答对的阶段中,首次答对之前的错误。
- DS:阶段内已经答对过,之后又出现的错误。
- PM:整个阶段从未答对,该阶段的所有步都计入。
下面用一个十步教学示例说明,竖线表示正确答案发生变化:
正确答案:A A | B B B B B | C C C
模型预测:X Y | B B X B X | X C C
A 阶段两步全错,计为 PM;B 阶段先答对,之后两次答错计为 DS;C 阶段首次答对前的一步计为 AL。其余五步为 ACC,因此:
四项共用该题的全部时间步作为分母,再跨问题取平均。因此,PM 衡量的是整段遗漏所占的时间,而不是遗漏了多少个阶段。这个分解让相同准确率背后的不同错误过程变得可见。
四. 实验结果与主要发现
4.1 RAG 的收益取决于模型配置
Base 使用累积的已见文本,超出预算时截去较早部分;RAG 则从已到达的文本块中检索相关内容,通常取 top-30。下表选取原文表 2 的全部五组非 Thinking 的 Qwen3 配置,比较 OAKS-B/All 的准确率,单位为 %。
| Qwen3 规模 | Base | RAG |
|---|---|---|
| 4B | 26.4 | 29.3 |
| 8B | 33.1 | 35.1 |
| 30B | 35.8 | 37.8 |
| 80B | 41.1 | 43.5 |
| 235B | 46.8 | 44.7 |
前四组提高了 2.0~2.9 个百分点,235B 则下降 2.1 个百分点。因此,RAG 的收益需要结合具体模型与任务设置判断。
4.2 准确率提高后,错误去了哪里
原文表 6 给出了 Qwen3-30B 在 OAKS-B、Base 设置下的错误构成,单位同样为 %:
| 配置 | ACC | AL | DS | PM |
|---|---|---|---|---|
| 非 Thinking | 35.8 | 6.9 | 34.0 | 23.2 |
| Thinking | 43.6 | 9.0 | 37.0 | 10.4 |
Thinking 配置的 ACC 提高 7.8 个百分点,PM 减少 12.8 个百分点,收益主要体现为整段遗漏的时间减少。与此同时,AL 和 DS 都增加了。
理解这一变化,需要把四项一起读:一个原本全错的阶段只要出现一次正确回答,剩余错误就可能从 PM 转入 AL 或 DS。因此,DS 上升不能单独解释成抗干扰能力下降。两行比较还涉及不同模型检查点和采样设置,应按两套完整配置理解。
4.3 知识流推进后,准确率怎样变化
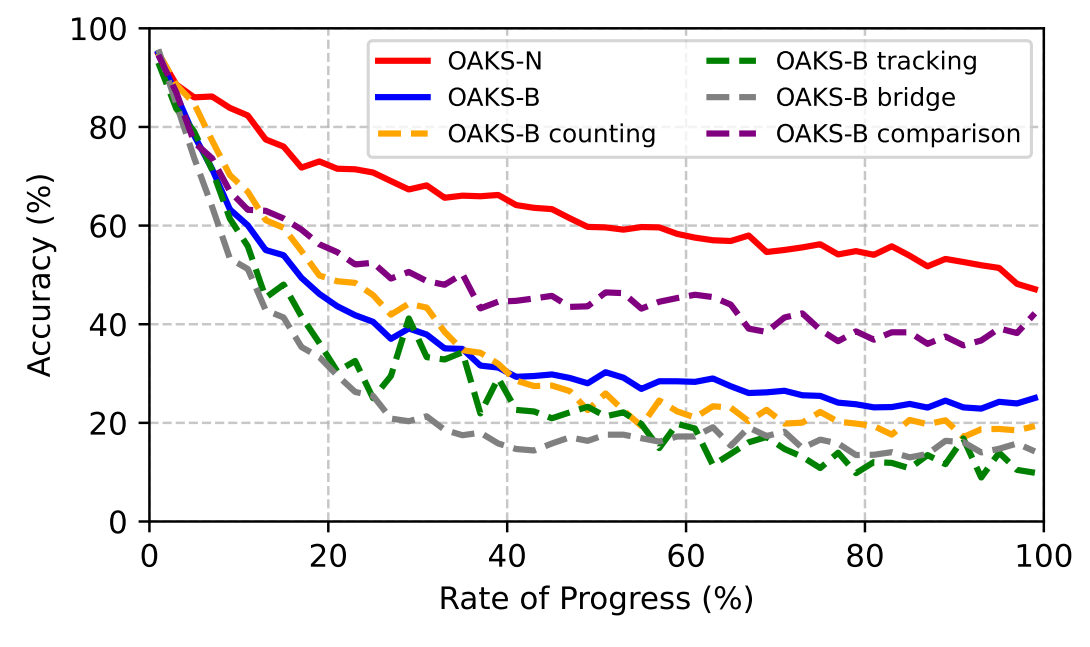
这张图来自 Qwen3-30B 的分析:横轴是知识流推进比例,纵轴是准确率。OAKS-B 的蓝色实线随进度整体下降,桥接与跟踪题在后段处于较低水平;OAKS-N 的红线下降相对较缓。早期答得好,并不代表能持续跟上。这也解释了为什么要沿时间评测。
五. 课题对齐思考
对食品证据知识构建与可信更新,OAKS 最值得借鉴的是把更新过程本身变成评价对象。包装图片、OCR 与补充材料逐步到达时,可以持续检查同一组食品命题:哪些应新增或修订,哪些应去重、保留冲突或暂缓,以及原本正确的命题是否被误改。
迁移时首先要对齐证据来源、计量口径和适用范围。例如,“每 100g”与“每份”的数值差异不一定代表事实变化。随后用真实食品数据标注每步应有的命题状态和行动,并通过强基线与知识回归检查更新效果。这样才能从答案跟踪进一步走向知识行动的可信评价。
这些错误轨迹还可以成为改进外部行动策略的候选反馈。它们能否在固定大模型下提升后续食品推理,需要用独立留出数据验证。对当前课题而言,可以先建立清楚的过程评测,再研究策略怎样从反馈中改善。