Author: Hongyu Wang, Chenda Li, Xin Zhou, Shuai Wang, Yanmin Qian
Unit: Shanghai Jiao Tong University;Nanjing University;Shenzhen Loop Area Institute
Journal: AAAI
Year: 2026
一、研究背景
二、核心贡献
三、方法
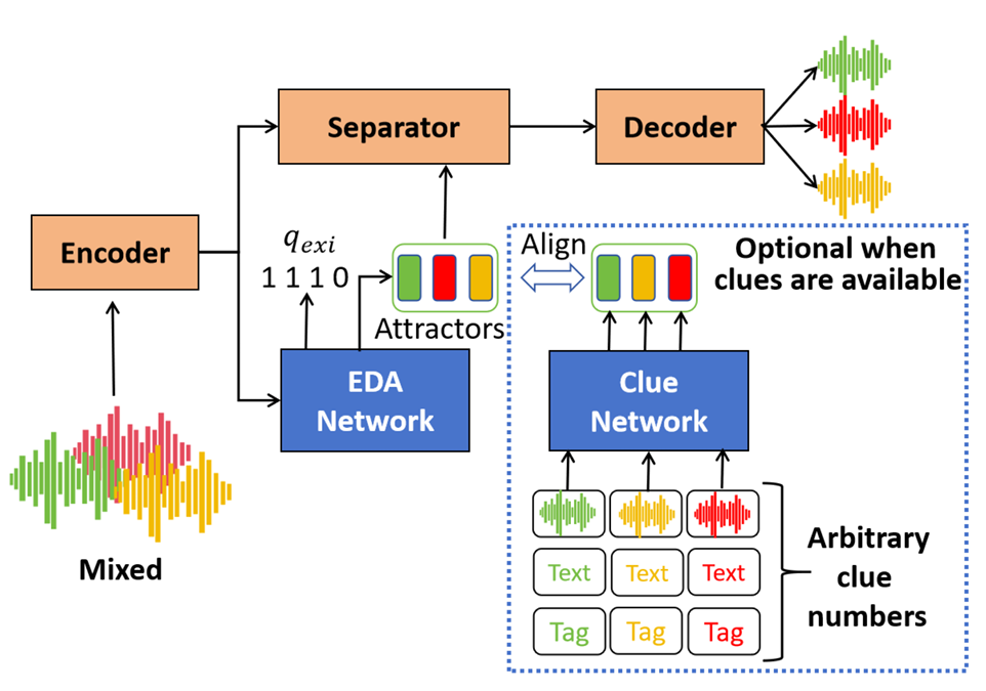
(1)共享分离主干: 混合音频经过 Encoder 提取特征,Separator 根据声源条件表示生成分离掩码,再由 Decoder 重建声源波形。
(2)无外部线索(USS): EDA Network 根据混合音频特征自动估计声源数量,并生成对应的 Attractor,引导共享分离主干分离所有声源。
(3)有外部线索(TSE): Clue Network 融合文本、视频和声音标签,生成 Clue embedding,替代 Attractor 引导同一分离主干提取目标声源。
核心机制:通过训练阶段的表示对齐,使 Attractor 与 Clue embedding 能够作为可替换的分离条件。
四、实验
1.实验准备
2.实验结果——Sound Separation & Source Counting
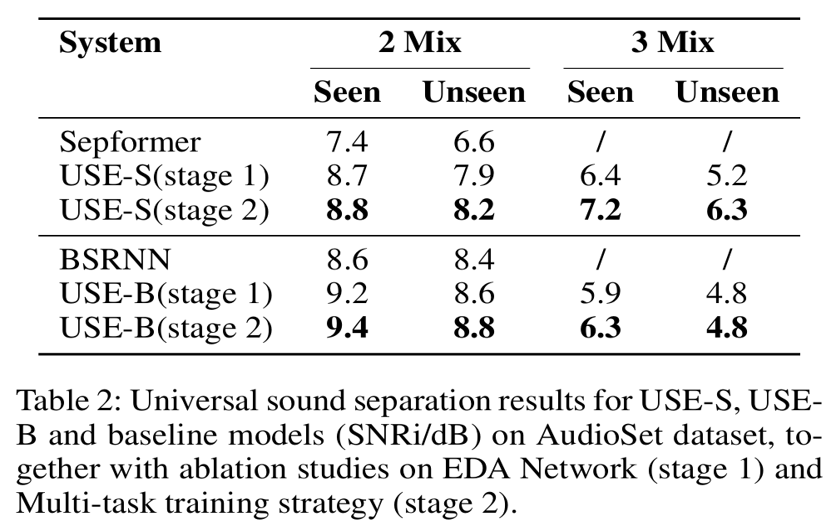
(1)引入 EDA 后,USE 能够在不预先指定声源数量的情况下完成 2Mix 和 3Mix 声音分离。
(2)声源数量估计在 2Mix 和 3Mix 中的准确率分别超过 80% 和 70%,但复杂混合场景下仍存在计数错误。
(3)第二阶段联合训练后,分离性能总体保持或小幅提升,说明统一训练未明显损害自主分离能力。
3.实验结果——Multi-modal Target Sound Extraction
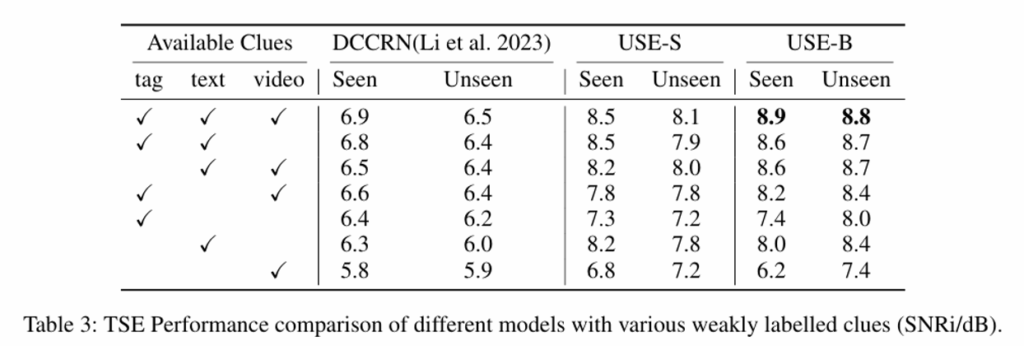
(1)USE 能够利用文本、视频和声音标签等不同线索组合完成目标声音提取。
(2)三种模态联合使用时整体表现较好,仅提供单一线索时也能完成提取,但不同模态的效果存在差异。
(3)相比 DCCRN,USE 在表中各线索组合下均取得更高的 SNRi,表明多模态条件提取具有一定优势。
4.实验结果——Unified Training Performance
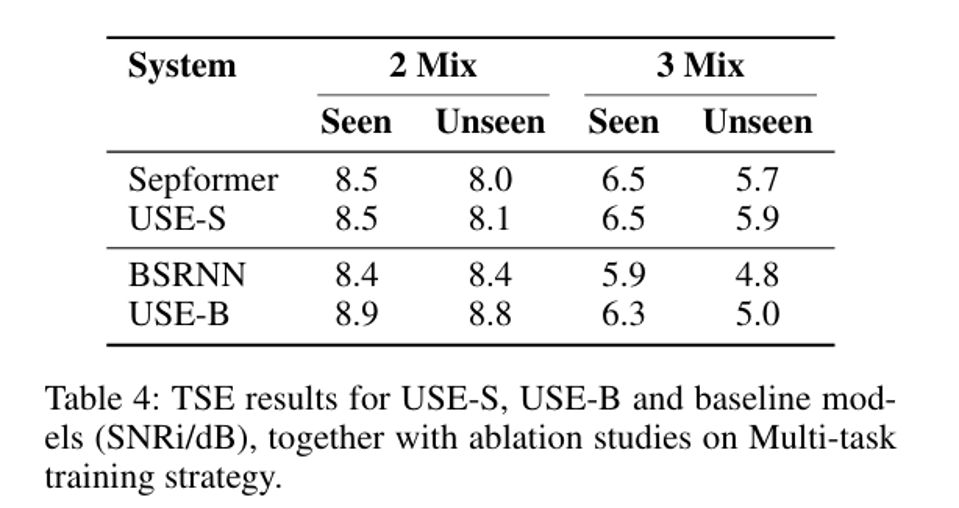
(1)联合训练后的 USE 在目标声音提取任务上,与单独训练的 SepFormer 和 BSRNN 相比,性能总体相当或略有提升。
(2)在 2Mix 和 3Mix、Seen 和 Unseen 场景中均呈现类似趋势,说明统一训练能够兼顾目标提取任务。
(3)结合前述分离实验,USE 能够在同一网络中保留 USS 和 TSE 两种能力。
5.实验结果——Attractor–Clue Representation Alignment
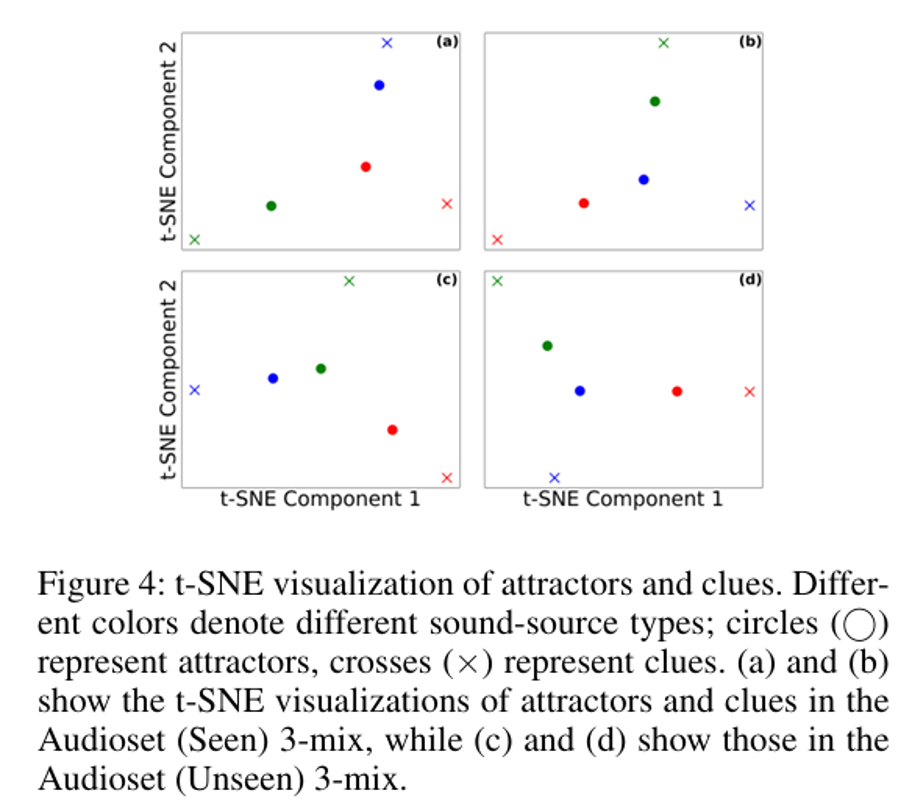
(1)声源特征分布: 不同类型声源在特征空间中呈现一定聚集趋势,但仍存在部分交叠。
(2)跨表示相似性: 相同声音类型的 Attractor 与 Clue embedding 在部分区域分布相近,但并未完全重合。
(3)未见类别表现: Seen 和 Unseen 场景均呈现一定的分布规律,但部分表示仍存在偏移。
6.实验结果——Variable Source Number Generalization
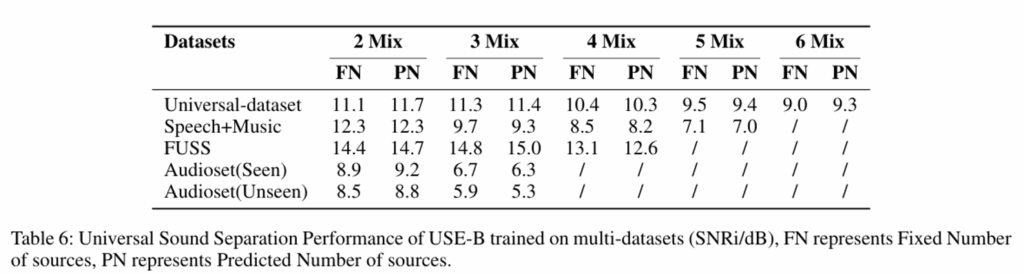
(1)USE 在多个声音数据集及 2~6 个声源的混合场景中均能够进行分离,但不同数据集和声源数量下性能存在差异。
(2)使用 EDA 预测声源数量与预先指定真实数量相比,分离性能总体接近,部分场景中甚至略有提升。
(3)随着混合声源数量增加,分离难度通常增大,说明声源数量适应能力仍受场景复杂度影响。
五、总结
(1)提出 USE 统一框架,将通用声音分离(USS)与目标声音提取(TSE)整合到同一个网络中,根据是否存在外部目标线索灵活切换自主分离和条件提取模式。
(2)通过 EDA 自动估计声源数量并生成声源 Attractor, 使声音分离不再要求用户提前指定需要分离的声源数量,提高了模型对复杂混合音频的适应能力。
(3)通过多模态 Clue Network 和跨任务表示对齐, 将文本、视频及声音标签线索映射到与Attractor 相兼容的表示空间,使模型可以使用不同来源的线索控制同一个分离网络。
(4)论文的核心创新不是单独提高分离网络的性能,而是建立统一的“声源条件表示”。 这一表示既可以从混合音频中自主产生,也可以由外部线索生成,从而连接自动声源发现与目标声音提取。
六、对齐思考
1.方法创新点——全域数据拓扑建模: USE 提供了一种从混合音频中自主建立声源表示、再通过外部线索进行目标关联的方法。EDA 可以生成不同声源对应的 Attractor,Clue Network 则将语义或视觉线索映射到相同表示空间,使内部声源表示与外部条件建立联系,为后续声源级语义绑定与结构化声场建模提供了参考。
2.技术目标点——虚实空间孪生推演: USE 可以在未知声源数量的情况下自动分离多个声音,也可以根据文本、视频和类别标签提取指定目标,但模型尚未显式建模声源方向、空间位置、长期轨迹和跨时间身份一致性,因此还不能直接构成完整的动态声场表示。
3.中试产品点——埃觅文旅: USE 可以从景区、街道等复杂环境声音中自主分离不同声源,也可以根据指定声音类别或文本描述提取特定环境声音。