Author: Dongheon Lee, Younghoo Kwon, Jung-Woo Choi
Unit:Korea Advanced Institute of Science and Technology(KAIST)
Journal: NeurIPS
Year: 2025
一、研究背景
二、核心贡献
三、方法
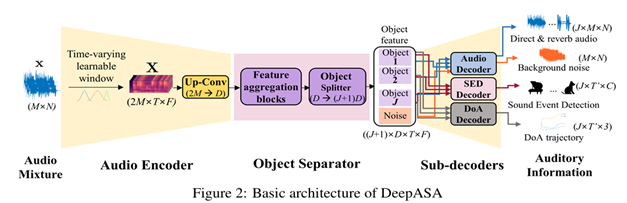
(1)对输入的多通道混合音频,首先使用 Dynamic STFT 提取复数时频特征。模型逐帧预测高斯窗的位置和宽度,使分析窗口能够根据声音内容动态调整时间和频率分辨能力。
(2)随后利用修改后的 DeFT-Mamba 聚合时间、频率和多通道空间关系,再通过 Object Splitter 将整个声场表示拆分为多个 foreground object 和一个独立的 noise object。
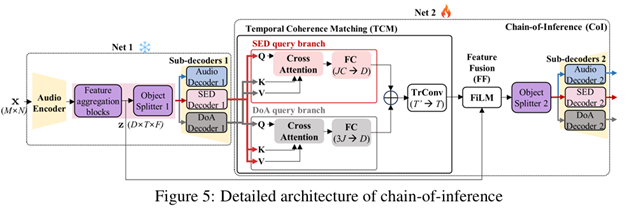
(3)每个声音对象分别进入 Audio、SED 和 DoA 解码器,预测对应的 direct/reverb 波形、声音类别、活动状态和空间方向;第一轮结果再通过 CoI 和 TCM 相互校验,并反馈到 object feature 中进行第二次推理
四、实验
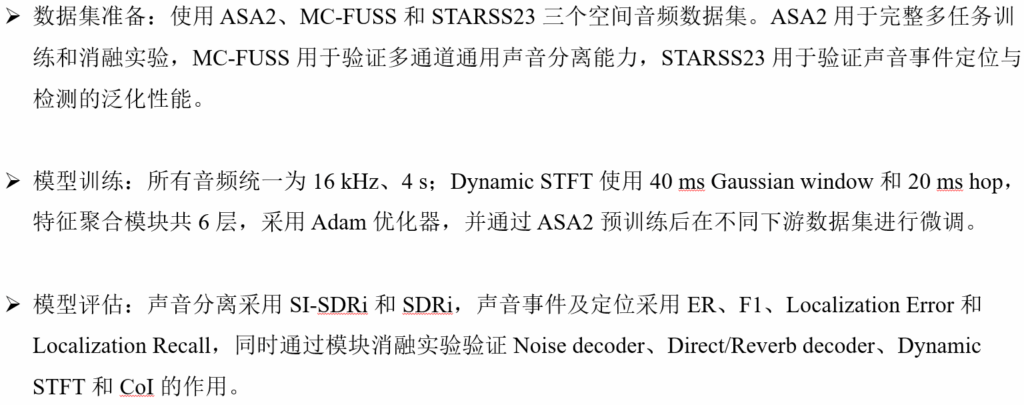
1.实验准备
2.实验结果——Ablation Study of DeepASA
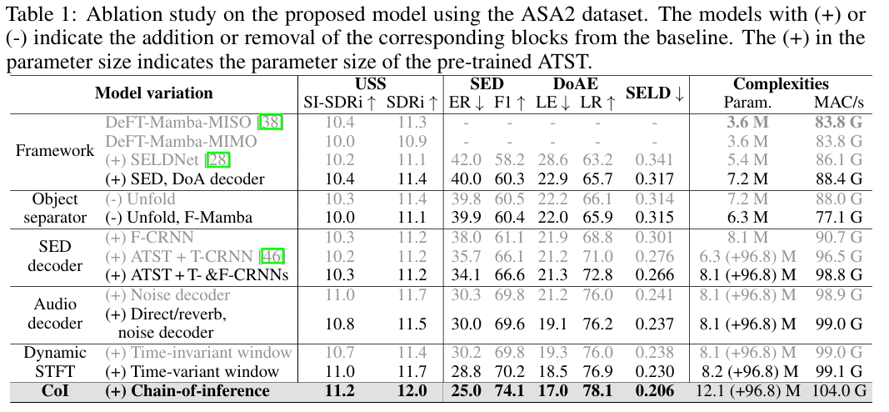
(1)随着 SED/DoA decoder、Noise decoder、Direct/Reverb decoder、Dynamic STFT 和 CoI 依次加入,模型从单一声音分离逐渐形成完整的 object-oriented auditory scene analysis 能力。
(2)显式建立 Noise object 能够帮助模型区分前景声音和背景噪声;Direct/Reverb 分开建模则有助于削弱混响对空间定位的影响。
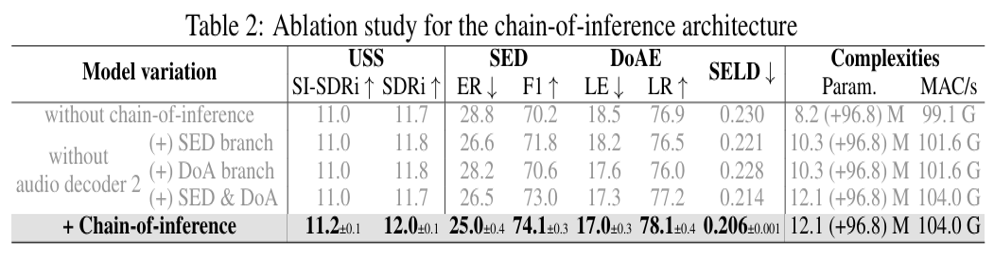
(3)Dynamic STFT 改善不同时间尺度声音的表示,而 CoI 进一步利用 SED 与 DoA 的互补关系修正 object feature,最终达到 SI-SDRi 11.2 dB、SELD score 0.206。
3.实验结果——Generalization to Spatial Audio Benchmarks
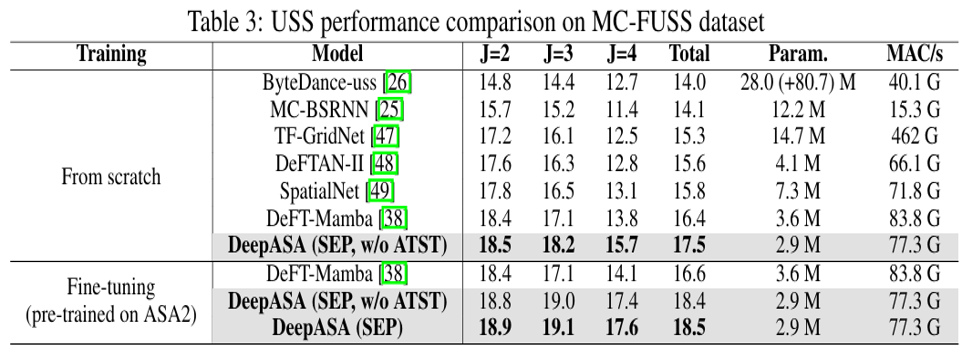
(1)在 MC-FUSS 通用声音分离任务上,ASA2 预训练后的 DeepASA 达到 18.5 dB SI-SDRi,并且在多声源重叠场景中仍保持较好的分离能力,说明 object representation 可以迁移到其他声音分离数据集。
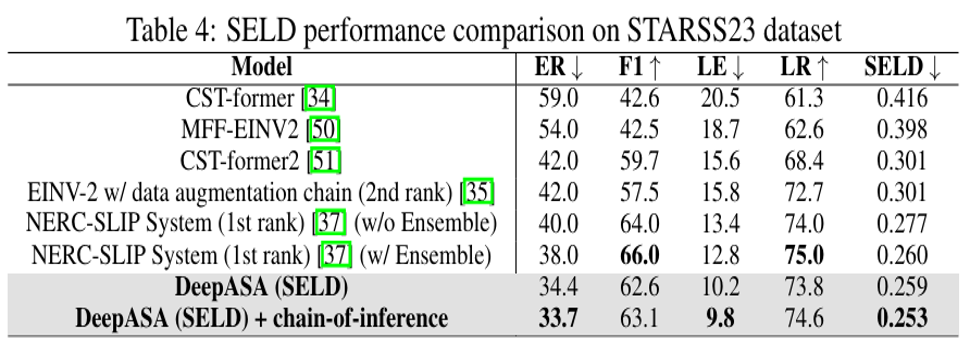
(2)在 STARSS23 SELD 任务上,DeepASA + CoI 获得 0.253 的综合 SELD score 和 9.8° 的定位误差,说明该方法不仅适用于作者构建的 ASA2,也能够迁移到真实空间音频数据。
五、总结
(1)提出 DeepASA 统一听觉场景分析框架,将声音分离、去混响、噪声估计、声音事件检测、分类和空间定位整合到同一个模型中。
(2)提出 Object-Oriented Processing,使声音的波形、类别、活动状态和空间位置围绕同一个 object 表示进行组织,减少传统 track-wise processing 中的信息关联问题。
(3)提出 Chain-of-Inference,通过 SED、DoA 等不同听觉线索之间的交互,对第一次形成的不完整 object representation 进行进一步修正。
(4)DeepASA 的核心意义并不只是“同时完成多个任务”,而是将听觉场景从多个独立预测结果进一步组织为“声音对象 + 对象属性 + 属性关系”的结构化表示。
六、对齐思考
1.方法创新点——全域数据拓扑建模: DeepASA 不再将语义、空间和声音内容作为互不相关的输出,而是围绕单个声源建立“Object—Attribute—Relation”结构,为进一步构建声源级结构化声场表示提供了参考。
2.技术目标点——虚实空间孪生推演: 模型能够同时描述“是什么声音、什么时候存在、来自哪里、对应什么声音信号”,相比单一全局 embedding,更接近可解释的声场对象建模。
3.中试产品点——埃觅文旅: 可将复杂环境声音解析为多个具有类别、时间和空间信息的声源对象,为景区声音识别、声源定位及声景评价提供结构化输入,并进一步解释“哪些声音、从哪里出现、持续多久”影响当前声景体验。