2026 年 9 月 20 日-guoshuaiqi
作者:Vikas Yadav,Gaurav,Ashmit Rana,Shivam Sharma
单位:Computer Science and Engineering,Chandigarh University,Gharaun, Punjab, India
来源:2025 IEEE 6th Global Conference for Advancement in Technology (GCAT)
一、研究背景
问题:
大语言模型(LLM)在医疗领域的应用,受限于其对静态、过时知识的依赖,以及其产生错误信息(即 “幻觉”)的倾向。
标准 RAG 系统引入外部知识库,能够缓解幻觉、接入最新知识、支持来源溯源,但在复杂的生物医学术语中难以获取相关且准确的信息
当前医疗 RAG 存在复杂临床问题多跳推理能力不足、模型黑盒可解释性差、缺乏输出真实性校验的短板,难以落地应用于临床。
研究目标:
验证假设:相较于标准 RAG 基线,融合知识图谱的多智能体 RAG 框架在复杂医学查询任务中可以显著提升准确率与忠实度。
二、核心贡献
- 提出 MedRAG-Agent 多智能体医疗 RAG 框架,将知识图谱导航与多智能体分工结合,模拟医学专家推理流程,专门解决医疗场景的检索难题与幻觉问题。框架包含 4 个专用智能体:查询拆解 Agent、知识图谱导航 Agent、文档检索 Agent、综合验证 Agent。
- 构建混合医疗知识库:数据源选用权威公开资源 MedlinePlus(基础医学知识)+PubMed(前沿科研摘要);同时构建生物医学知识图谱,借助 UMLS 统一医学语言系统对齐实体与关系,结合 FAISS 向量库完成非结构化文本检索。
- 内置回答忠实度校验机制,定义忠实度损失函数,强制每一条生成的陈述都要有检索原文证据支撑,输出附带引用标注,降低幻觉。
三、方法
创建了一个名为MedRAG-Agent框架的模块化多智能体系统,以模仿医学领域人类专家的推理过程
3.1 知识库构建
使用MedlinePlus语料库获取可靠的基础医学信息,并使用PubMed的摘要获取最新的研究结果。在初始数据处理过程中,使用pubmed-parser Python库解析复杂的MEDLINEXML格式。为了保持文本的语义完整性,随后使用了一种结构感知分块技术。
生物医学知识图谱:对文本块应用命名实体识别(NER)来识别重要的医学概念,以确保图谱的结构是一致且合乎逻辑的。然后将这些医学信息之间的关系与UMLS或统一医学语言系统进行比较
3.2 方法工作流
- Agent1:Query Decomposer 查询拆解智能体:拦截复杂的用户查询,拆解为一系列逻辑上更简单的子问题。
- Agent2:KG Navigator 知识图谱导航智能体:针对每个子问题查询生物医学知识图谱,提取核心实体、实体关系,输出结构化上下文,用于过滤、约束后续文档检索范围。
- Agent3:Document Retriever 文档检索智能体:结合子问题 + KG 输出的过滤上下文,在向量知识库做定向稠密向量检索,提取最合适的文本片段。
- Agent4:Synthesizer and Verifier 合成与验证智能体:综合检索到的片段生成逻辑连贯的回答;执行关键的验证,增加行内引用、标记任何缺乏依据的表述,逐条核对生成语句是否存在源证据,标记无依据断言,输出经过验证、带来源标注的最终答案。
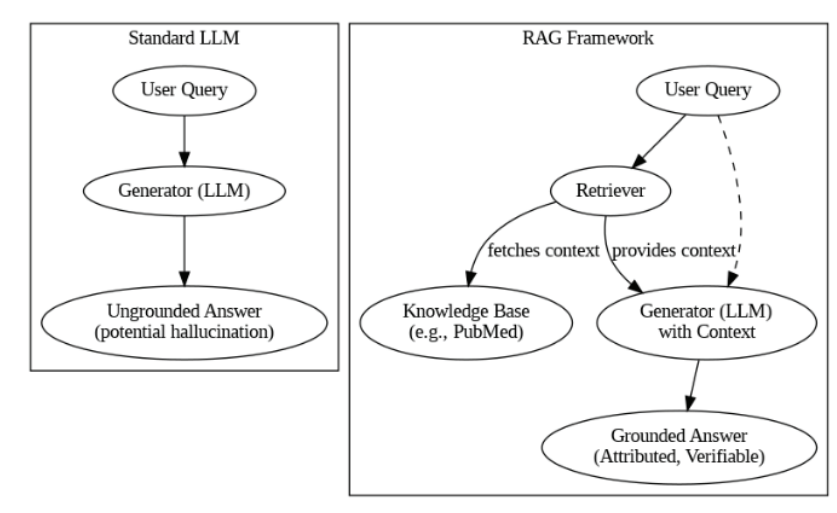
标准 LLM 与 RAG 架构对比。该图将仅基于预训练数据的标准 LLM,与从外部来源获取答案、从而提供更多最新信息的 RAG 框架进行了比较
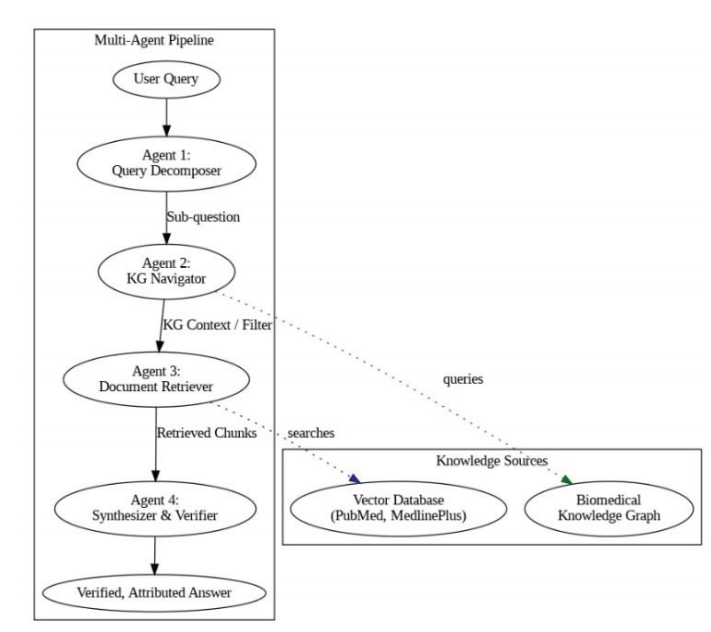
MedRAG-Agent 框架架构总览。该图展示了用户查询被四个专门智能体顺序处理的过程,以及它们与知识源之间的交互。
3.3 模型训练与技术
- 检索模型:在 PubMed 日志训练的领域检索模型;
- 生成与智能体推理:GPT-4o、Claude3.5 Sonnet;
- 向量库:FAISS。
四、实验
4.1实验准备
测试数据集:MedQA(USMLE 医学考试数据集)、MIRAGE 基准。
对比基线:Vanilla RAG、i‑MedRAG、KG‑RAG。
评价指标:准确率(1‑5 分)、可信度 Faithfulness (%)、完备性 Completeness (1‑5)。
4.2 整体性能对比实验
在 MedQA(USMLE)数据集和 MIRAGE 基准上,将 MedRAG-Agent 与 Vanilla RAG(基础 RAG 基线)、i-MedRAG、KG-RAG 等现有方案对比,从准确率、忠实度、完整性三个维度验证框架的整体性能提升
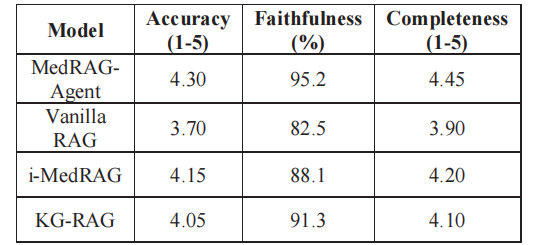
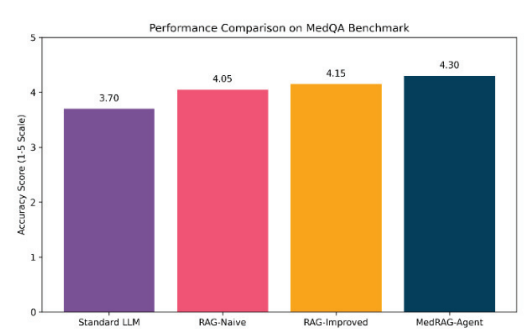
MedRAG‑Agent 达到 78.5% 准确率;对比 Vanilla RAG,准确率相对提升 12%,忠实度提升 12.7%,幻觉降低约 15%,完备性同样优于对比模型。
4.3 消融实验
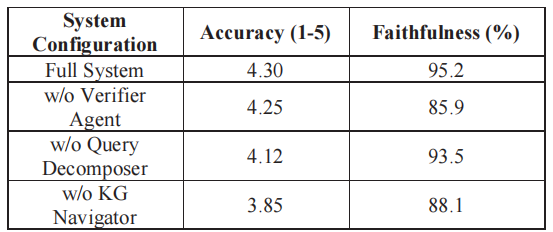
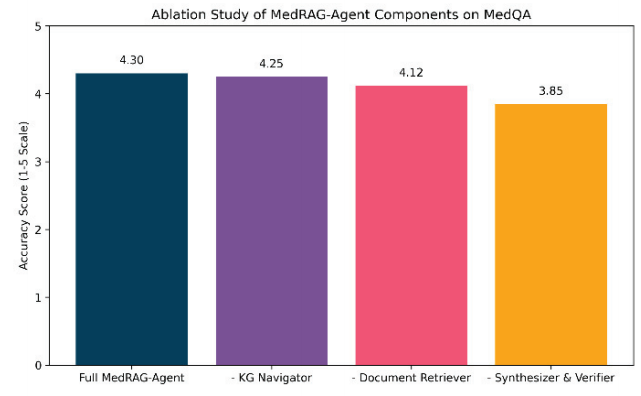
依次移除系统中的关键智能体(验证器、查询分解器、知识图谱导航器),观测性能下降的幅度,验证各个核心组件对准确率和忠实度的贡献,佐证知识图谱增强与多智能体设计的实际价值。
实验结论:
1. KG-Navigator移除后准确率下跌幅度最大,证明知识图谱约束检索、过滤噪声是模型核心;
2. Verifier 验证 Agent 对忠实度影响最大,去掉后忠实度大幅下降近10个百分点,是抑制幻觉的关键;
3. 查询拆解也带来正向收益,但贡献弱于前两者。
五、总结
1) 提出 MedRAG-Agent 多智能体医疗 RAG 框架,使单一框架能够同时完成复杂医学查询拆解、知识图谱引导检索与生成结果忠实度校验,为大语言模型提供更可靠的医学领域检索增强推理方案。
(2) 提出任务特定的四智能体结构,分别为查询拆解、知识图谱导航、文档检索、合成验证建立独立的信息路径与处理逻辑,使不同推理环节能够选择适配自身任务的信息处理方式。
(3) 融合结构化生物医学知识图谱与非结构化权威医学文献并保持高效检索协同,并通过忠实度校验机制将幻觉内容占比降低约 15%。
(4) 实验验证 MedRAG-Agent 同时提升基础医学问答准确率与下游回答忠实度;在 MedQA 数据集上较 Vanilla RAG 基线准确率相对提升 12%,说明知识图谱增强的多智能体架构能够有效改善大语言模型的医学信息理解能力
六、思考
1.技术创新 —— 知识图谱增强的多智能体 RAG 框架:以往医疗 RAG 多采用单阶段检索 – 生成流水线架构,难以同时应对复杂生物医学术语理解与多步临床推理需求;本文进一步将分阶推理延伸至检索与生成全链路,通过查询拆解、知识图谱导航、文档检索、合成验证四智能体串行协作,实现检索过程的结构化降噪与生成内容的证据化校验,推动医疗 RAG 从 “单步检索增强” 走向 “多智能体闭环事实推理”。
2.技术目标 —— 医疗问答准确率与忠实度协同优化:以往研究侧重于提升医疗问答的回答准确率,对生成内容的事实一致性与可溯源性管控不足;本文将其拓展为检索精度约束与生成事实校验的双向优化,通过知识图谱前置过滤检索噪声与验证器后置逐句证据核对,在 MedQA 数据集上较 Vanilla RAG 基线准确率相对提升 12%、幻觉内容降低约 15%,显著增强了大语言模型在医疗高风险场景下的可靠性与实用价值。