作者:Ji-Hoon Kim,Jaehun Kim,Joon Son Chung
单位:Korea Advanced Institute of Science and Technology(KAIST)
来源:AAAI Conference on Artificial Intelligence(AAAI 2024)
论文链接:https://doi.org/10.1609/aaai.v38i3.28055
1. 背景
唇语生成(Lip-to-Speech,LTS)的目标是从没有声音的人脸视频中恢复对应语音。它可以用于修复历史无声影像、为失语人群生成自然语音,也可以辅助理解远距离拍摄但没有清晰录音的对话。
这项任务的核心困难并不只是“从图像生成声音”,而是唇部运动与语音之间存在天然的一对多映射。
- 同唇异音:不同音素可能呈现几乎相同的唇形。例如,“bit”和“pit”的唇部运动十分接近,仅依赖视觉信息容易产生错读。
- 语音变化:相同的语音内容可以具有不同的音色、音高、能量和语调。传统模型直接回归 Mel 频谱,容易把多种可能的语音平均化,产生模糊、过度平滑的结果。
已有方法通常采用 Mel 频谱作为预测目标,但没有充分解决上述两类不确定性。部分工作引入文本监督改善发音,却需要额外的人工转录。本文希望在不依赖文本标注的条件下,同时提高生成语音的可懂度和自然度。
2. 主要贡献
- 利用自监督语音表示提供语言监督。作者从 HuBERT 中提取与音素相关的离散语言单元,让视觉网络学习从唇形预测语言内容,从而缓解同唇异音问题。
- 显式预测音高和能量。模型将音高与能量作为声学方差信息注入解码过程,减少视觉到语音映射的不确定性,并增强韵律表现。
- 使用 Flow-based Post-Net 细化频谱。流模型学习复杂的声学分布,恢复普通 L1/L2 回归容易丢失的谐波和高频细节。
- 在受控与非受控数据集上验证效果。模型在 GRID 和 Lip2Wav 上均超过现有方法,生成语音的主观自然度、可懂度及识别错误率得到明显改善。
3. 方法
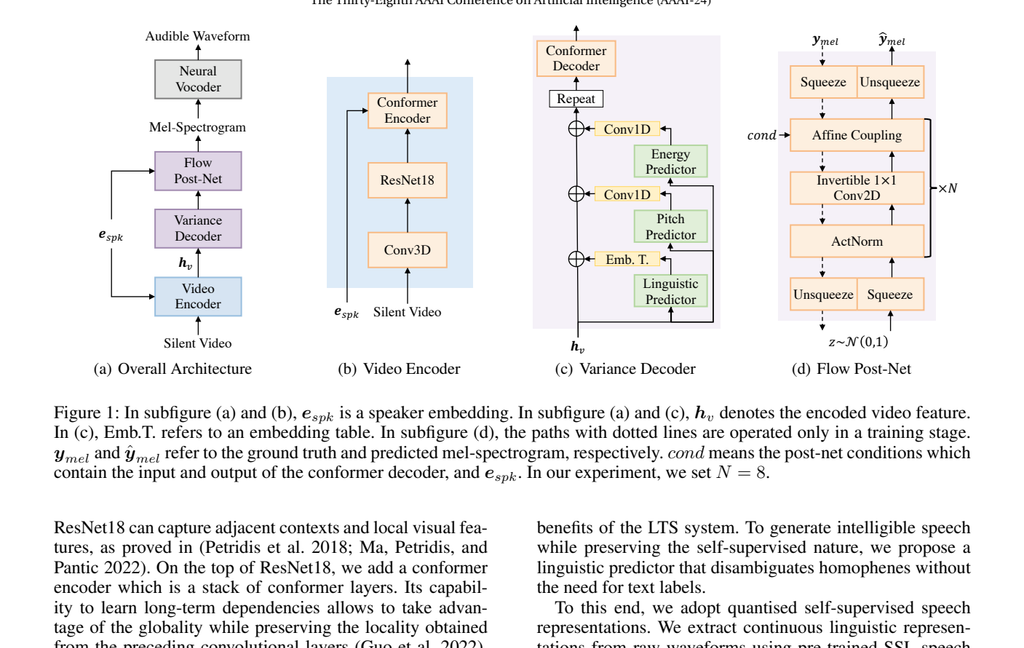
模型由视频编码器、方差解码器和 Flow Post-Net 三部分组成。视频编码器从静音人脸视频中提取视觉特征;方差解码器结合语言、音高和能量信息生成粗粒度 Mel 频谱;Flow Post-Net 进一步恢复频谱细节。最后,预训练 Fre-GAN 将 Mel 频谱转换为 16 kHz 语音波形。
3.1 视频编码器
视频编码器由 3D 卷积、ResNet18 和 Conformer 编码器组成。3D 卷积与 ResNet18 提取相邻视频帧中的局部口型变化,Conformer 进一步建模长时间依赖。模型还通过说话人嵌入表示不同个体的视觉和声音特征。
3.2 自监督语言预测器
作者首先使用预训练 HuBERT-LARGE 从训练音频中提取连续语音表示,再用 K-means 将表示量化为离散语言单元。实验比较了 HuBERT 第 1、12 和 24 层,以及 100、200 个聚类中心。第 12 层配合 200 个聚类中心取得最低的音素错误率和字符错误率,因此成为最终配置。
训练阶段,语言预测器根据视频特征预测每个时间步的离散语言单元,并使用交叉熵损失进行优化。这样,模型不需要人工文本转录,也能获得与发音相关的监督信息。
3.3 音高与能量预测
音高预测器使用 pYIN 从真实语音中提取基频序列,并通过 L1 损失学习从视觉特征估计音高。能量预测器把 Mel 频谱沿频率轴的 L2 范数作为目标,同样使用 L1 损失训练。
语言单元通过嵌入表转换为向量,音高和能量则通过一维卷积编码。三类表示与视觉特征相加,再送入 Conformer 解码器生成粗粒度 Mel 频谱。显式提供这些条件,可以简化目标声学分布,减少一对多映射带来的模糊。
3.4 Flow Post-Net 与声码器
单纯依赖 L1 或 L2 重建损失时,模型倾向于生成多种可能结果的平均值,频谱会出现过度平滑。本文采用条件可逆流网络学习真实 Mel 频谱的概率分布。训练时,网络把真实频谱映射到高斯先验并最小化负对数似然;推理时,从先验分布采样并通过逆向流生成细粒度频谱。
最终的 Mel 频谱由 Fre-GAN 转换为波形。与部分早期工作采用的 Griffin-Lim 相比,Fre-GAN 能更好地保持频率一致性。
4. 实验
4.1 数据集与评价指标
- GRID:包含 33 名说话人,每人约 50 分钟视频,词汇量有限,人物基本保持正面姿态,属于受控场景。
- Lip2Wav:来自真实演讲视频,词汇量更大,人物姿态和拍摄条件更复杂。论文使用 Chemistry 和 Chess 两名说话人的数据。
主观评价采用自然度和可懂度 MOS,由 30 名领域专家对随机语音片段打分。客观评价使用自动语音识别结果计算词错误率(WER)和字符错误率(CER)。
4.2 主要结果
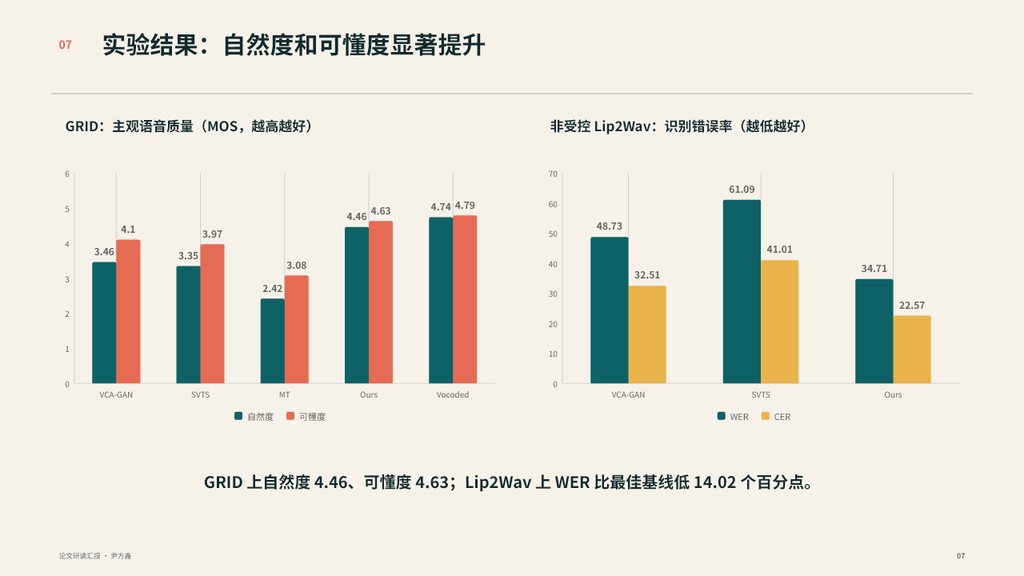
在 GRID 上,本文方法的自然度 MOS 为 4.46,可懂度 MOS 为 4.63,分别只比基于真实频谱重建的 Vocoded Speech 低 0.28 和 0.16。与 VCA-GAN、SVTS 和 MT 相比,模型在主观听感和识别错误率上均取得更好结果。
在更复杂的 Lip2Wav 上,本文方法取得 4.15 的自然度 MOS、3.69 的可懂度 MOS、34.71% 的 WER 和 22.57% 的 CER。相较最佳基线 VCA-GAN,WER 降低 14.02 个百分点,说明自监督语言信息能够在非受控场景中有效改善发音准确性。
4.3 消融实验
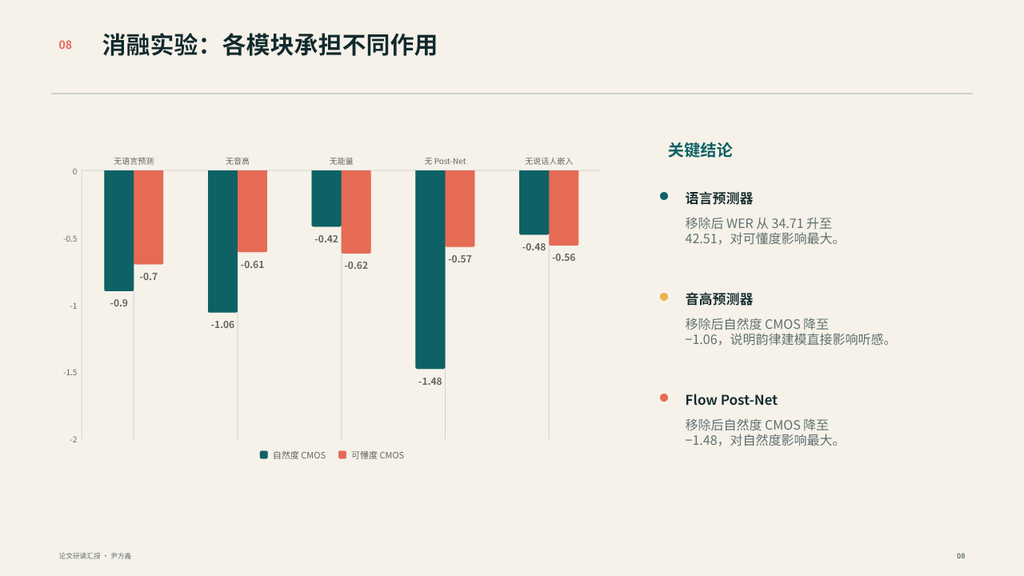
移除语言预测器后,WER 从 34.71% 上升至 42.51%,CER 从 22.57% 上升至 27.99%,说明语言预测器对消除同唇异音和提高可懂度最关键。
移除音高预测器时,自然度 CMOS 降至 −1.06,表明韵律信息直接影响语音听感。移除 Flow Post-Net 后,自然度 CMOS 降至 −1.48,是自然度下降最大的设置,证明流模型在恢复细粒度声学信息方面发挥了主要作用。
5. 课题价值与启发
5.1 跨模态缺失信息补全
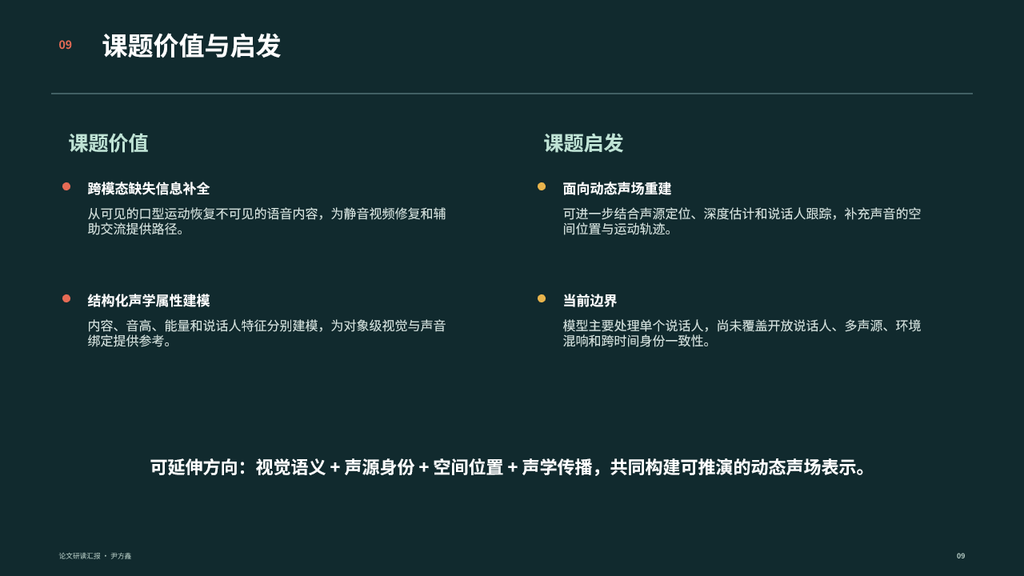
论文证明了视觉运动不仅可以用于识别人正在说什么,还可以作为恢复缺失听觉信息的条件。对于多模态空间建模,这提供了一条重要路径:当某种模态缺失或质量较差时,可以利用与其时间同步的其他模态进行补全。
5.2 结构化声学属性建模
本文没有把视觉特征直接映射到最终波形,而是将语言内容、音高、能量和说话人特征分别建模。这种“先解析中间属性,再完成跨模态生成”的方法更容易解释,也便于控制。类似思想可以扩展到对象级声音表示,将声源身份、声音内容、强度和时间变化分别编码,再与视觉对象建立关联。
5.3 从唇语生成走向动态声场重建
当前模型主要处理单个说话人的正脸视频,尚未显式建模声源方向、空间距离、房间混响、多声源干扰和跨时间身份一致性。因此,它还不能直接形成完整的动态声场表示。
进一步研究可以结合声源定位、深度估计、说话人跟踪和空间音频生成,将“口型到语音”扩展为“场景对象—声源身份—空间位置—声音内容—声学传播”的统一建模,为虚实空间孪生和动态场景推演提供更加完整的听觉信息。
6. 总结
《Let There Be Sound》围绕唇语生成中的一对多映射问题,从语言内容、声学韵律和频谱细节三个层面提出解决方案。HuBERT 离散表示提高发音准确性,音高与能量预测器增强韵律,Flow Post-Net 则改善频谱细节和自然度。实验表明,该方法在受控和非受控数据集上均显著超过已有模型。
这项工作也说明,高质量跨模态生成需要对不确定性进行显式分解。对于面向空间的多模态研究,后续可以把这种分层生成思路与对象定位、空间关系和声学传播结合,推动从局部语音恢复走向完整动态声场重建。