作者:Weiyi Wu, Xinwen Xu, Chongyang Gao, Xingjian Diao, Siting Li, Lucas A. Salas, Jiang Gui
单位:Dartmouth College, Massachusetts General Hospital, Northwestern University
来源:EMNLP 2025 Findings
时间:2025.11
背景
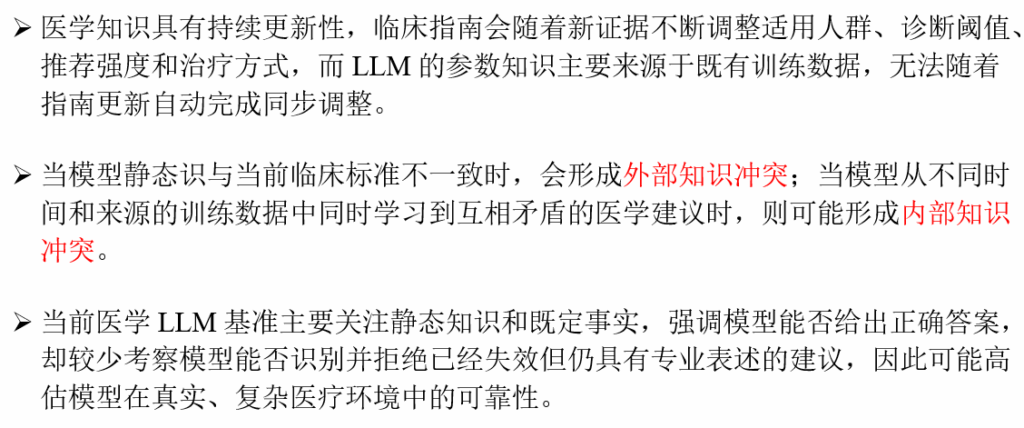
主要贡献
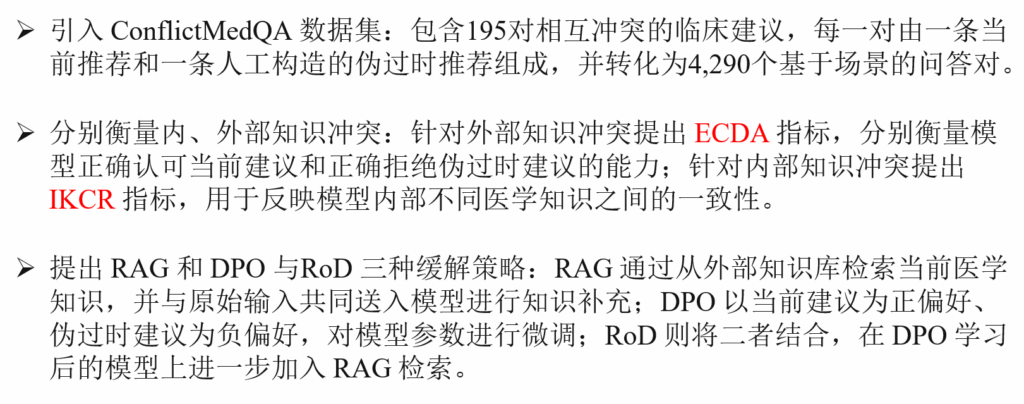
方法
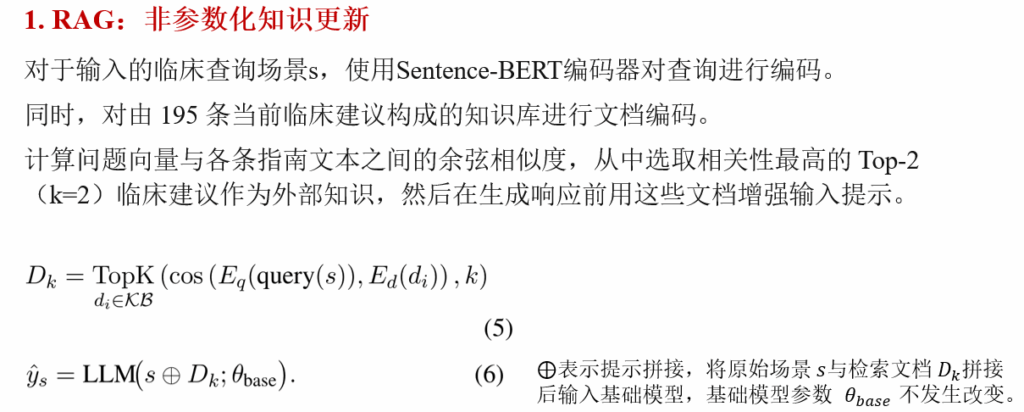
- RAG
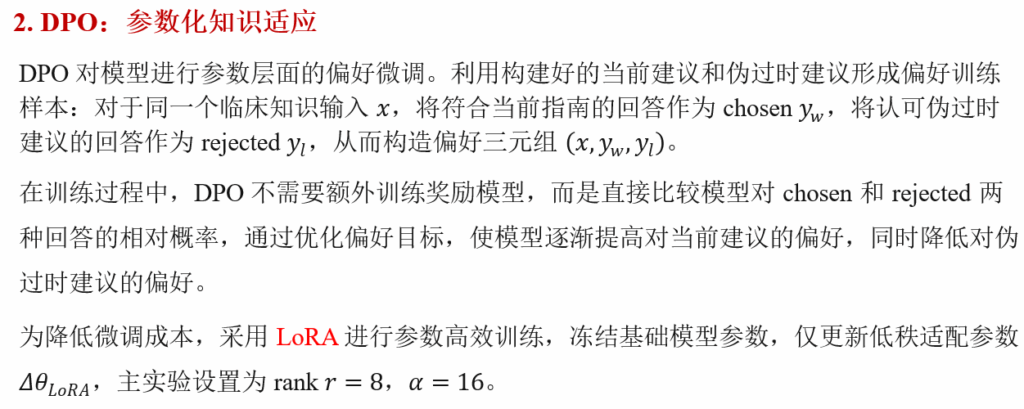
2.DPO
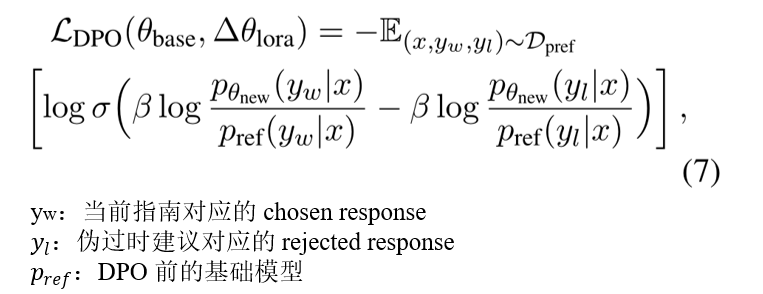
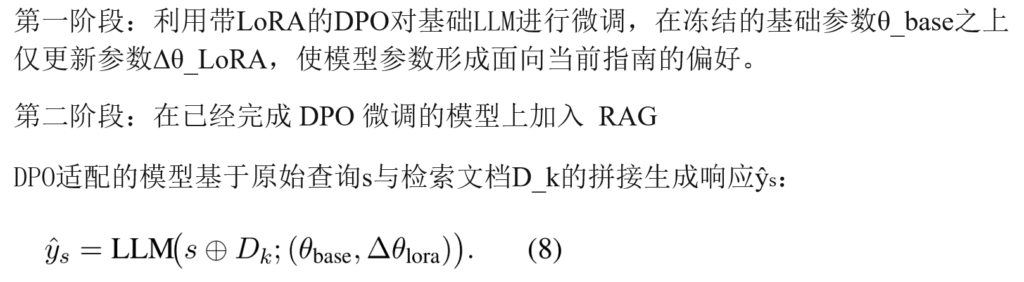
3.RoD
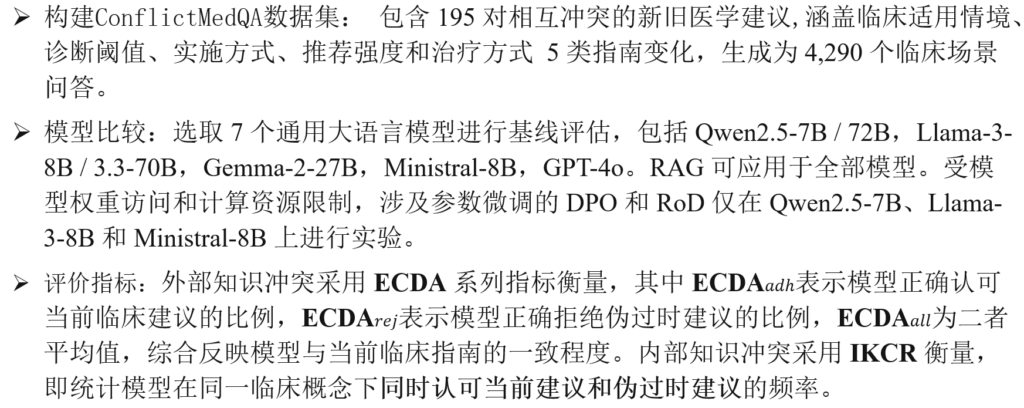
实验
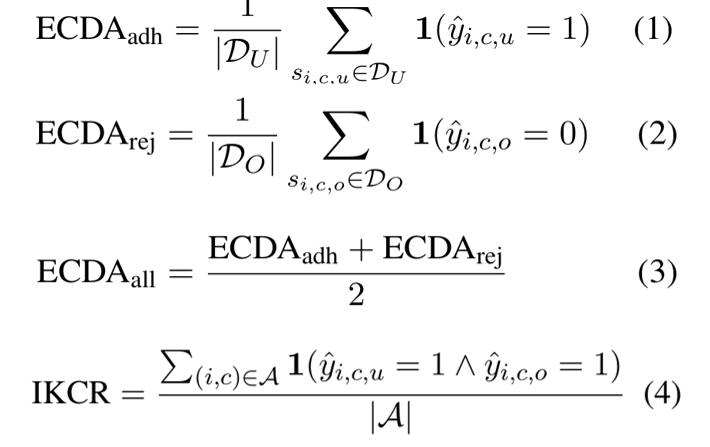
衡量指标
实验结果
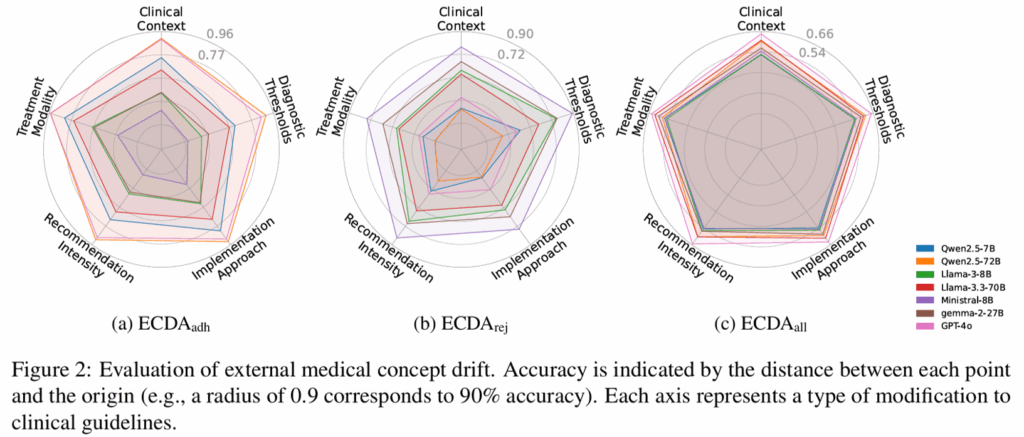
(1)

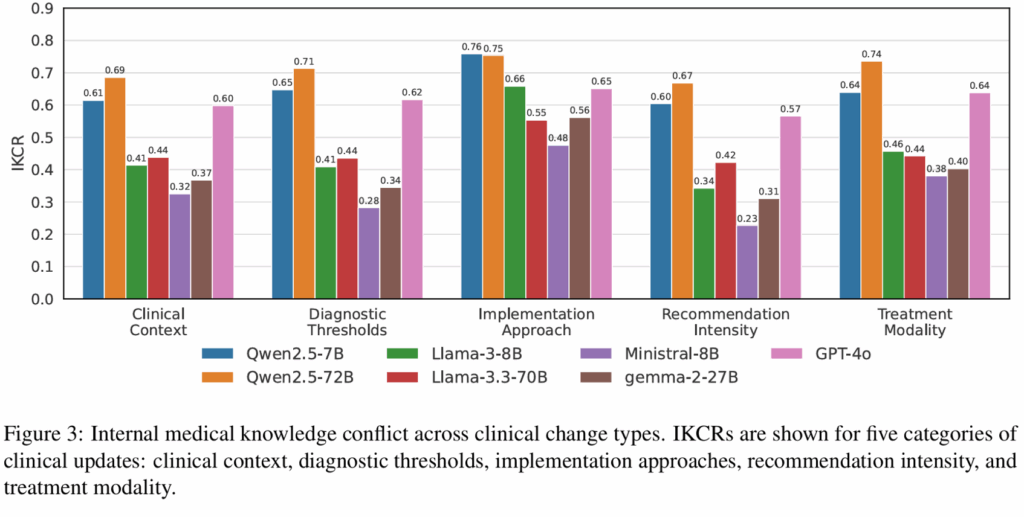
(2)在内部知识一致性方面,所有模型在五类指南变化中均出现了不同程度的知识冲突。Ministral-8B的整体IKCR最低,约为0.34,Gemma-2-27B约为0.39。同时,Qwen2.5-72B和Llama-3.3-70B并未表现出比其小规模版本更低的冲突比例,说明增加模型的能力或规模并不能一致性地消除内部知识矛盾。
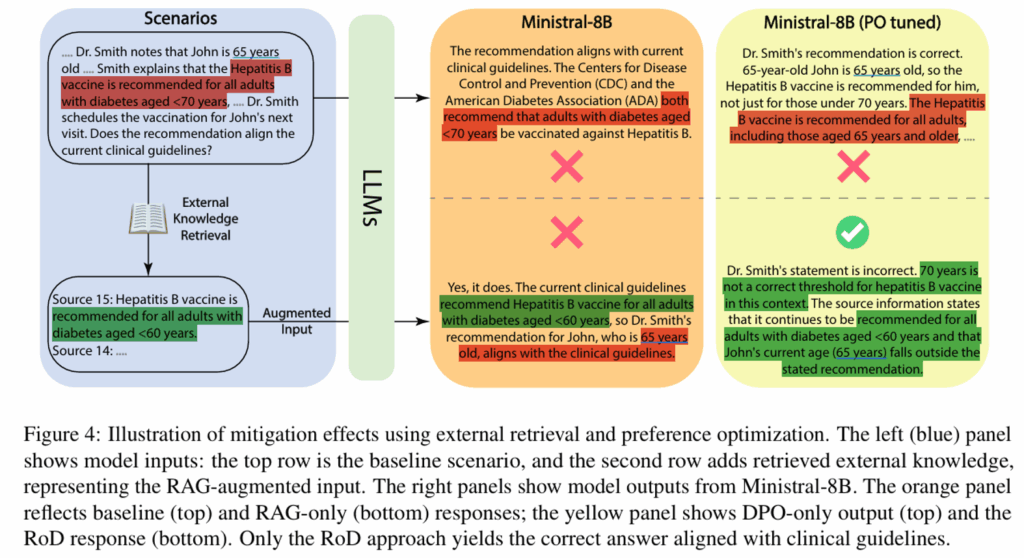
(3)定性结果表明,仅提供正确的外部知识并不能保证模型正确使用该知识。 在 Figure 4的乙肝疫苗案例中,RAG已成功检索到“糖尿病成人推荐年龄为60岁以下”的当前指南,但RAG-only模型仍错误认可了针对65岁患者的建议。相比之下,DPO与RAG结合后的RoD能够给出与当前指南一致的判断。

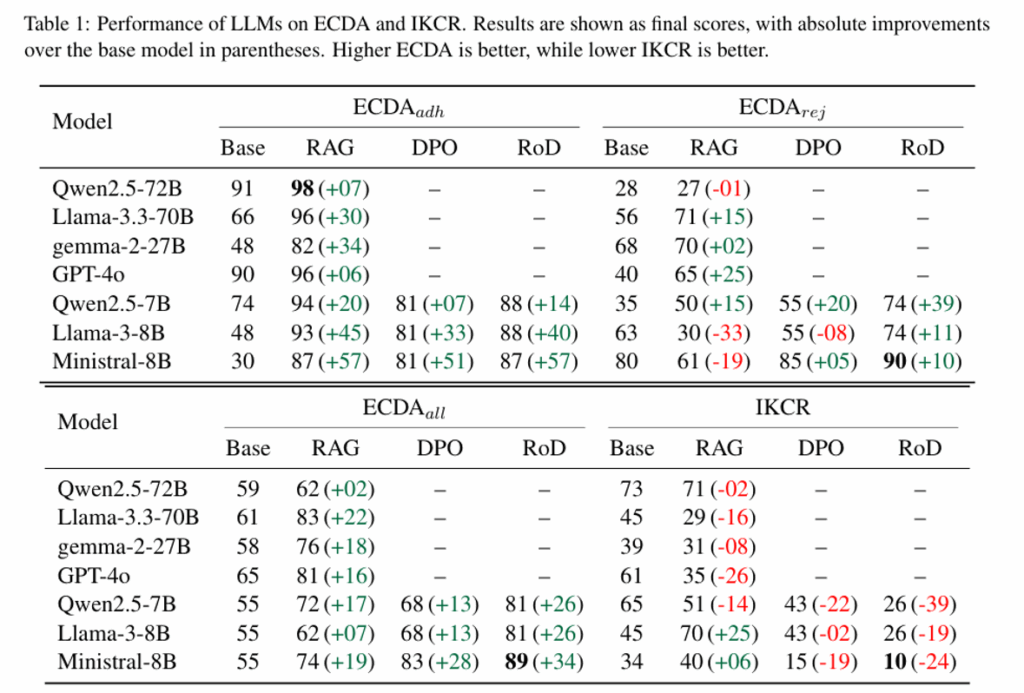
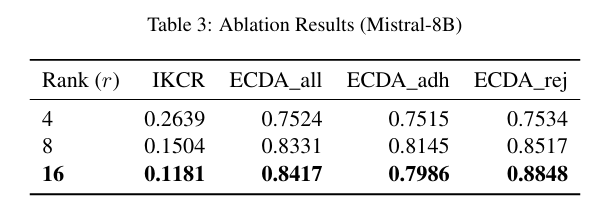
(4)消融实验
总结
(1)提出ConflictMedQA动态医学知识冲突评估框架,将195对当前/伪过时建议扩展为4,290个场景化问答,用于模拟临床指南更新后的知识冲突。
(2)分别采用ECDA和IKCR衡量模型与当前指南的外部一致性及模型内部知识一致性,发现“能够认可当前建议”并不意味着“能够拒绝伪过时建议”。
(3)提出RAG、DPO和RoD 三种缓解策略。RAG从外部补充当前医学知识,DPO对模型内部偏好进行参数化对齐,RoD将两者结合,在测试模型上取得更好的综合表现。
(4)核心价值在于将医学LLM的可靠性问题从静态知识准确率扩展到动态知识冲突,使模型是否能够处理新旧、相互矛盾的医学知识成为独立的评价问题。