作者:Tianchen Deng1, Xun Chen3, Ziming Li1, Hongming Shen3, Shuhao Zhai4,Danwei Wang3, Javier Civera2, Hesheng Wang1
单位:上海交通大学;南洋理工大学
来源:ECCV 2026
背景
➢ 问题: 传统视觉地点识别(VPR)通常被建模为单幅图像检索任务:给定当前查询图像,从数据库中检索与其对应的已访问地点。但单视图只能利用当前图像中的外观信息,在季节变化、昼夜变化、天气变化以及大视角变化下容易受到纹理变化影响。
➢ 核心思路: 多视角图像能够提供更大的场景覆盖范围以及不同观察方向下的空间信息,但现有多帧 VPR 方法主要仍是在时间维度聚合单帧 2D 特征,缺乏对多视角之间三维结构关系的显式建模,因此容易受到帧率、运动速度和序列稀疏程度变化的影响。
➢ 研究契机: VGGT(Visual Geometry Grounded Transformer)能够仅根据 RGB 多视图图像生成具有三维几何感知能力的表示,为 VPR 从传统的2D 外观匹配进一步扩展到多视角几何结构匹配提供了基础。
贡献
➢ 提出 UniPR-3D,作者称其为首个基于 3D Token 的 VPR 框架,将 VGGT 的多视角三维表征引入地点识别,同时支持单帧检索和序列级检索。
➢ 联合利用 2D Token 与 3D Token 构建地点描述子:2D 特征负责描述纹理和语义信息,3D 特征负责描述场景几何与空间结构,使二者形成互补。
➢ 针对不同 Token 特性设计差异化聚合策略:数量较少的 CLS/Register Token 使用 GeM Pooling,大量 Patch Token 使用基于 Optimal Transport + Sinkhorn 的聚合方法,以保留细粒度空间对应关系。 ➢ 提出可变长度多帧特征聚合方法,训练时使用固定长度序列,但推理时能够处理不同数量的输入图像,提高序列 VPR 对实际采样方式变化的适应能力。
方法
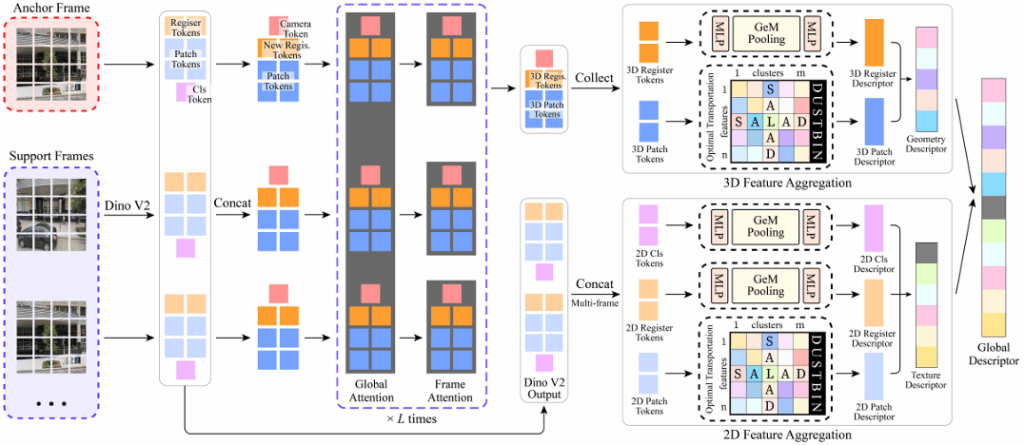
➢ 多视角特征提取: 输入单幅图像或图像序列,首先通过 DINOv2 Encoder 提取 2D CLS Token、Register Token 和 Patch Token;随后将 Patch Token 输入 VGGT 的 Frame Attention + Global Attention 交替模块,进一步生成具有多视角几何信息的 3D Camera、Register 和 Patch Token。
➢ Token 选择: 2D 分支保留 CLS + Register + Patch Token;3D 分支为了增强视角不变性,舍弃包含相机姿态信息的 Camera Token,仅使用 3D Register Token 和 3D Patch Token 构建几何描述。整个过程不需要额外输入相机内外参,仅依赖 RGB 图像。
➢ Register/CLS 特征聚合: 对数量较少的 2D CLS、2D Register 和 3D Register Token,先经过 MLP 投影,再利用 GeM Pooling 聚合为紧凑描述子:
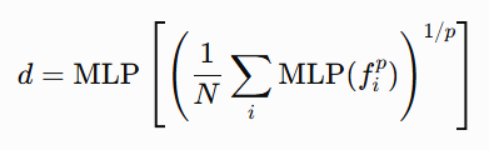
其中 pp 为可学习的池化参数。
➢ Patch 特征聚合: 对数量较多的 2D/3D Patch Token,采用类似 SALAD 的 Optimal Transport 聚合。网络学习 Patch 与特征簇之间的 Assignment Score,并增加 Dustbin 吸收天空、道路、动态物体等无效特征,再使用 Sinkhorn Algorithm 得到最优软分配矩阵,最终聚合为 Patch Descriptor。
➢ 统一地点描述子: 最终将
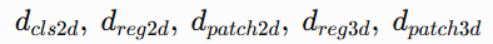
五部分拼接,得到统一 Global Descriptor,用于数据库最近邻检索。➢ 序列匹配: 多帧输入时,以第一帧作为 Anchor Frame、其余帧作为 Support Frames。跨帧 CLS/Register Token 采用 GeM 聚合,Patch Token 则联合多个帧后进行 OT 聚合,使多个观察视角最终压缩为一个序列级地点描述子,并支持可变长度序列。
实验
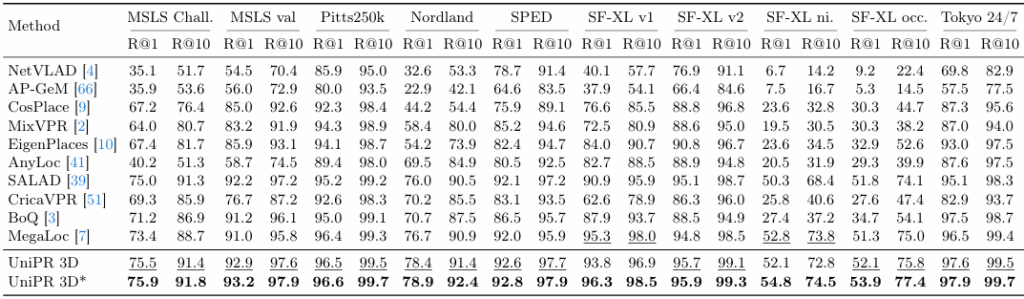
➢ 实验设置: 单帧模型在 GSV-Cities 上训练,并在 MSLS、Pittsburgh250k、NordLand、SPED、Tokyo 24/7、SF-XL 等多个数据集上测试;序列模型在 MSLS 上训练,并在 MSLS、NordLand、Oxford1、Oxford2 上测试。统一采用 Recall@k 作为评价指标。
➢ 单帧检索性能: UniPR-3D 在多数数据集和评价指标上超过 NetVLAD、CosPlace、MixVPR、SALAD、MegaLoc 等方法。例如 NordLand 上 R@1 从 SALAD 的 76.0% 提升至 78.4%,表明 3D 几何特征能够进一步增强传统单帧 VPR 的鲁棒性。
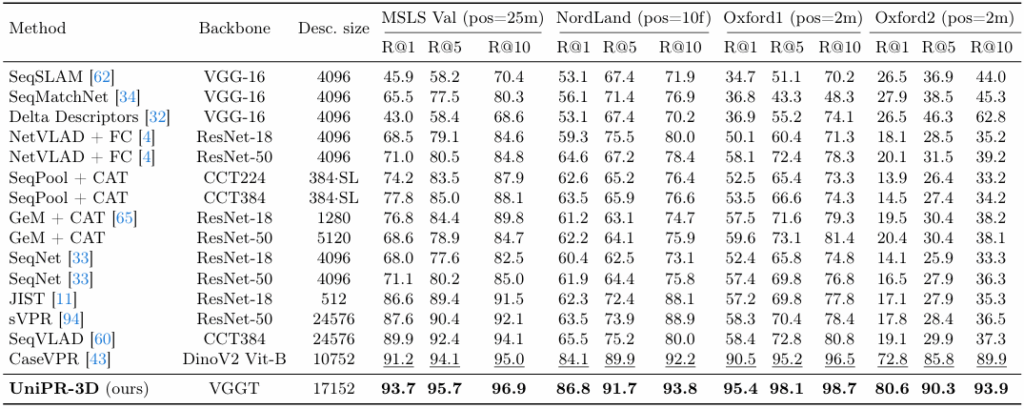
➢ 序列检索性能: 在 Oxford1 的严格 2 m 阈值下,UniPR-3D 的 R@1 达到 95.4%,高于 CaseVPR 的 90.5%;Oxford2 上 R@1 从 72.8% 提升至 80.6%,说明多视角 3D Token 对序列匹配具有明显作用。
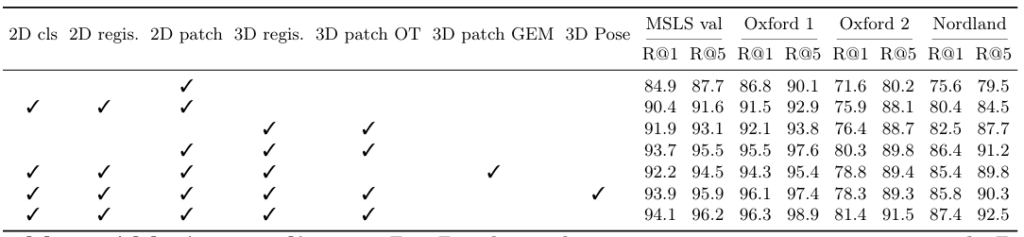
➢ 消融实验: 2D Patch 主要关注海报、售货亭、自行车等纹理丰富区域,3D Patch 更关注墙体、建筑物等结构稳定区域;显式加入相对 3D Pose 反而略微降低性能,说明 VGGT 的 3D Token 已经隐式编码了较充分的空间关系。
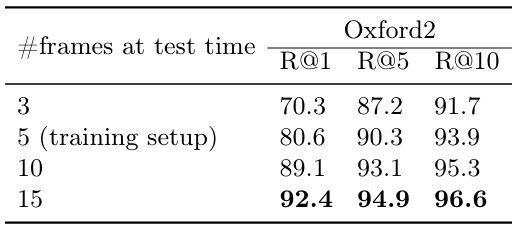
➢ 可变长度能力: 模型训练时序列长度仅为 5,但测试时输入 3、10、15 帧均能正常工作,并且 Oxford2 R@1 随帧数从 70.3% → 80.6% → 89.1% → 92.4% 持续提升,验证了多帧聚合模块对不同序列长度的泛化能力。
总结
➢ UniPR-3D 利用 VGGT 将多个视觉观测转换为具有三维几何感知能力的 Token,使 VPR 同时依据纹理和空间结构判断地点。
➢ 2D 与 3D 特征具有明显互补性: 2D Token 更适合描述局部纹理和语义信息,3D Token 更适合捕获稳定的几何结构,因此联合表示能够增强对光照、天气、季节以及视角变化的鲁棒性。
➢ 多帧并非简单时间平滑: 相比传统序列 VPR 沿时间维度累积相似度,UniPR-3D 在多帧之间建立几何感知特征表示,使连续图像成为一个统一的空间级地点描述子。
➢ 代价与局限: 3D 几何表征带来了额外计算开销,例如 Oxford 实验中 UniPR-3D 的推理延迟高于 CaseVPR;因此其优势主要体现在识别鲁棒性与跨视角泛化,而计算效率仍存在进一步优化空间。